Hướng Dẫn · 8 phút đọc · 2026-09-18
Chạy AI trên máy tính bằng Ollama: đo 3 mô hình trên RTX 3080 Ti, tốc độ, bộ nhớ và lỗi tiếng Việt
Mình chạy gemma4:e4b, qwen3.5:9b và gemma4:12b bằng Ollama trên RTX 3080 Ti: 65 đến 120 token mỗi giây, chỉ CPU thì chậm khoảng 10 lần. Cả ba ghi sai tiền thối khi được bảo trả lời ngắn, và qwen chèn chữ Hán vào câu tiếng Việt.
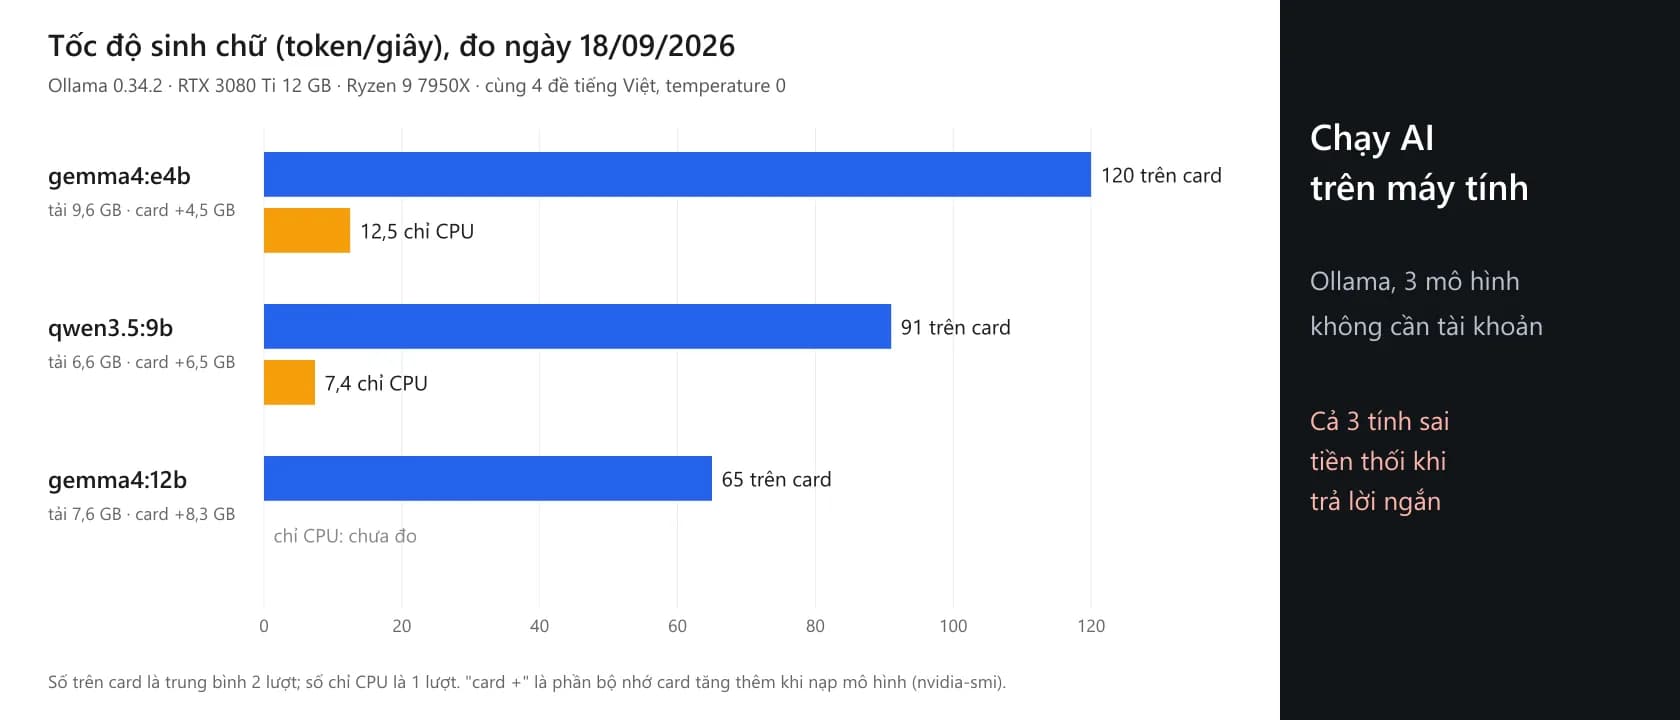
Chạy AI trên máy tính nghĩa là tải một mô hình ngôn ngữ về ổ cứng và để nó trả lời ngay trên máy của bạn: không cần tài khoản, không trả phí theo lượt, không gửi nội dung lên dịch vụ nào. Ngày 18/09/2026, mình cài Ollama 0.34.2 trên Windows 11 và đo ba mô hình trên card RTX 3080 Ti 12 GB: gemma4:e4b, qwen3.5:9b và gemma4:12b.
Những gì đo được:
- Trên card, tốc độ từ 65 đến khoảng 120 token mỗi giây. Một đoạn giới thiệu 80 chữ xong trong 1 đến 2 giây.
- Chỉ dùng CPU thì chậm khoảng 10 lần: 12,5 và 7,4 token mỗi giây.
- Tên mô hình không cho biết nó nặng bao nhiêu: gemma4:e4b tải về 9,6 GB, nặng hơn bản 12b (7,6 GB).
- Hỏi một phép tính kèm yêu cầu "trả lời ngắn", cả ba mô hình đều ghi sai tiền thối ở dòng đầu. Hai cách sửa đều cho kết quả đúng trong lần thử.
- qwen3.5:9b chèn chữ Hán vào giữa một câu tiếng Việt.
Nhận xét về tiếng Việt trong bài là mô tả các câu trả lời cụ thể mình nhận được, không phải đánh giá chung cho từng mô hình.
Chạy AI trên máy tính cần máy thế nào
Máy thử: AMD Ryzen 9 7950X (16 nhân), 64 GB RAM, NVIDIA RTX 3080 Ti 12 GB, driver 591.86. Trước khi nạp mô hình, màn hình và các ứng dụng khác đã chiếm sẵn khoảng 2,5 GB bộ nhớ card, nên Ollama báo còn trống 10,8 GiB.
Tài liệu Windows của Ollama yêu cầu Windows 10 bản 22H2 trở lên và driver NVIDIA từ 551.61. Phần mềm cần ít nhất 4 GB ổ đĩa; mô hình thì từ vài GB tới hàng trăm GB tuỳ loại.
Câu hỏi "Ollama cần bao nhiêu VRAM" không có một con số chung, vì nó phụ thuộc mô hình. Với ba mô hình mình thử, phần bộ nhớ card tăng thêm khi nạp (đo bằng nvidia-smi) là:
- gemma4:e4b (tải về 9,6 GB): tăng khoảng 4,5 GB, card đang dùng tổng 7,0 GB.
- qwen3.5:9b (6,6 GB): tăng khoảng 6,5 GB, tổng 9,1 GB.
- gemma4:12b (7,6 GB): tăng khoảng 8,3 GB, tổng 10,9 GB.
Với gemma4:12b, card 12 GB chỉ còn trống khoảng 1 GB. Nếu card của bạn còn trống ít hơn con số ở cột giữa, mô hình không nằm gọn trên card. Mình chưa thử trường hợp này.
Cài Ollama trên Windows và đổi chỗ lưu mô hình
Cách thông thường là tải OllamaSetup.exe từ trang chủ Ollama. Bộ cài không cần quyền Administrator và mặc định cài vào thư mục người dùng trên ổ C, còn mô hình lưu ở %HOMEPATH%\.ollama. Ba mô hình trong bài đã chiếm gần 24 GB, nên nếu ổ C chật, bạn nên đổi chỗ ngay từ đầu:
- Đổi chỗ cài: chạy
OllamaSetup.exe /DIR="D:\Ollama". - Đổi chỗ lưu mô hình: tạo biến môi trường
OLLAMA_MODELScho tài khoản của bạn, rồi mở lại Ollama.
Mình dùng bản zip ollama-windows-amd64.zip (1,46 GB, giải nén ra 1,8 GB) để mọi thứ nằm ở ổ khác. Mở một cửa sổ PowerShell trong thư mục giải nén:
$env:OLLAMA_MODELS = "D:\ai-local\models"
.\ollama.exe serve
Mở cửa sổ thứ hai để tải và chạy mô hình:
.\ollama.exe pull gemma4:e4b
.\ollama.exe run gemma4:e4b
Lúc khởi động, log của ollama serve có dòng "inference compute" ghi library=CUDA, tên card RTX 3080 Ti, total="12.0 GiB" và available="10.8 GiB". Có dòng này tức là Ollama đã nhận card.
Ollama có miễn phí không? Ollama dùng giấy phép MIT. Hai họ mô hình trong bài, Gemma 4 và Qwen3.5, theo lệnh ollama show --license đều là Apache 2.0. Tải mô hình không cần đăng nhập. Chi phí thật là phần cứng và tiền điện.
Ollama models: dung lượng tải về khác với tên gọi
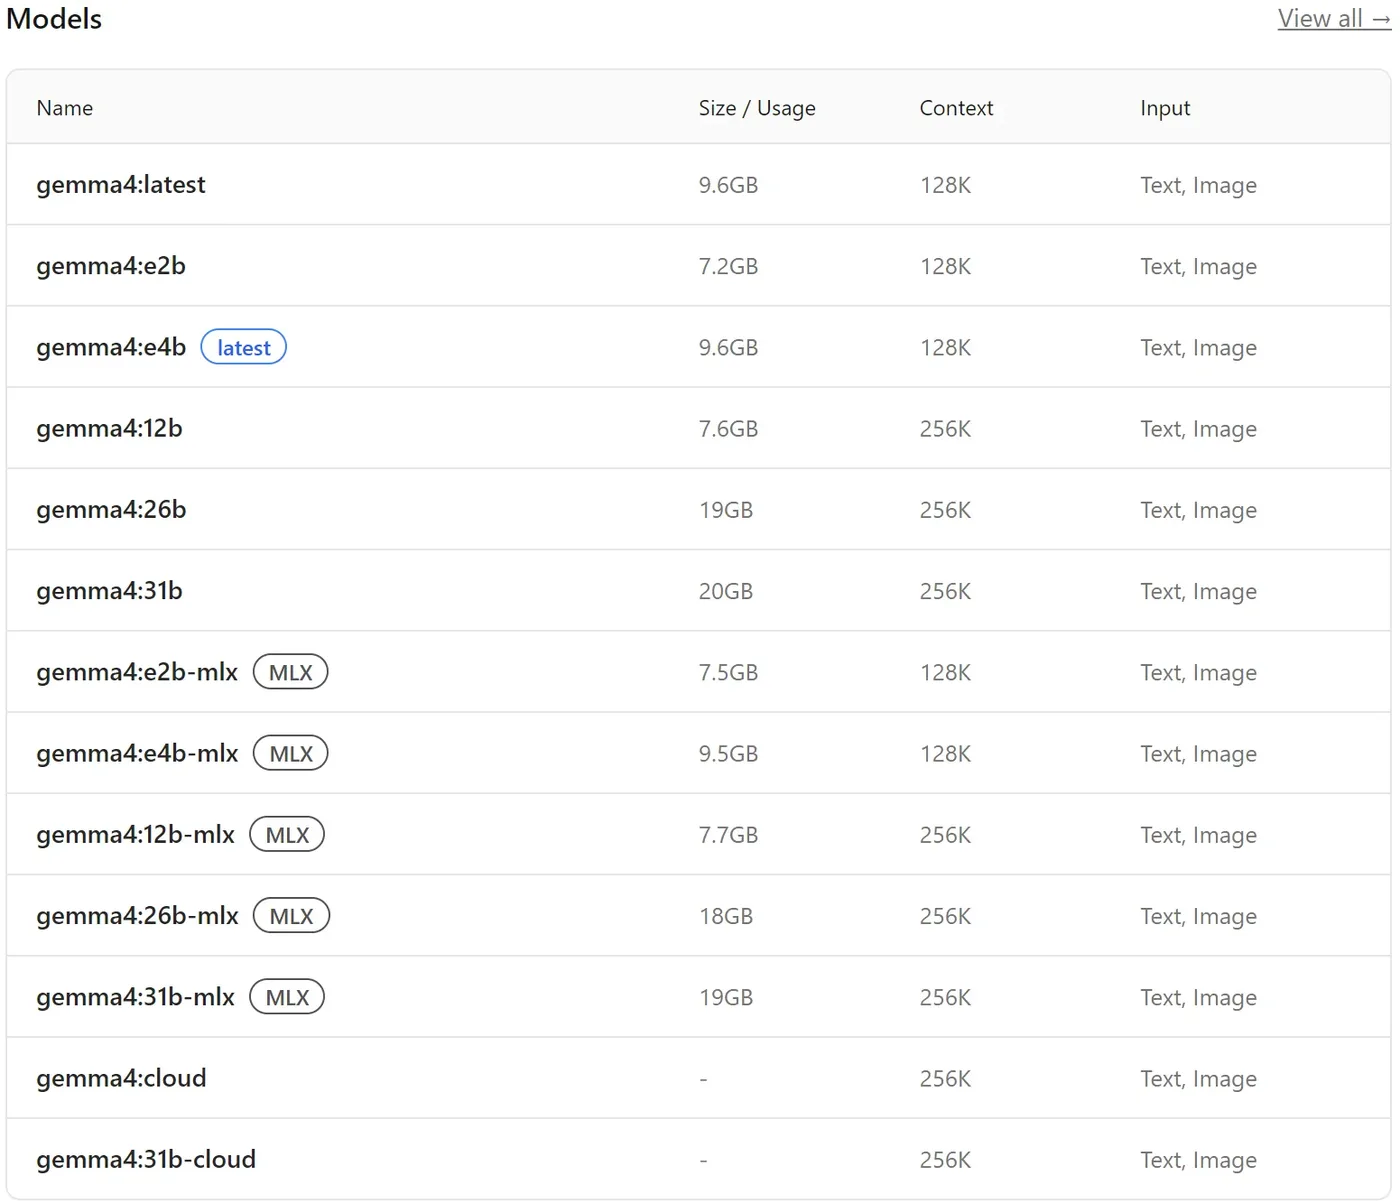
Trang thư viện của Ollama cho thấy hai điều cần biết trước khi tải:
gemma4không kèm đuôi chính là bảne4b, nặng 9,6 GB. Gõollama run gemma4là tải bản này.- Bản e4b tải về nặng hơn bản 12b, dù tên nghe như nhỏ hơn. Khi chạy trên card, lệnh
ollama pslại báo e4b chỉ chiếm 3,2 GB (nvidia-smi thấy bộ nhớ card tăng khoảng 4,5 GB).
Lệnh ollama list sau khi tải xong ba mô hình:
NAME          ID              SIZE      MODIFIED
gemma4:12b    4eb23ef187e2    7.6 GB    20 minutes ago
qwen3.5:9b    6488c96fa5fa    6.6 GB    22 minutes ago
gemma4:e4b    c6eb396dbd59    9.6 GB    24 minutes ago
Thời gian tải trên đường mạng của mình: 207 giây cho e4b, 129 giây cho qwen3.5:9b, 142 giây cho 12b. Cả ba đều là bản lượng tử hoá Q4_K_M; số tham số lần lượt là 8,0 tỷ, 9,7 tỷ và 11,9 tỷ.
Ollama chạy GPU hay CPU: đo tốc độ cả hai
Lệnh ollama ps cho biết mô hình đang chạy ở đâu. Cùng gemma4:e4b, chạy trên card và ép chạy CPU cho hai kết quả:
NAME          ID              SIZE      PROCESSOR    CONTEXT    UNTIL
gemma4:e4b    c6eb396dbd59    3.2 GB    100% GPU     4096       4 minutes from now

NAME          ID              SIZE      PROCESSOR    CONTEXT    UNTIL
gemma4:e4b    c6eb396dbd59    9.4 GB    100% CPU     4096       4 minutes from now
Khi chạy CPU, mô hình chiếm 9,4 GB RAM thay vì 3,2 GB bộ nhớ card.
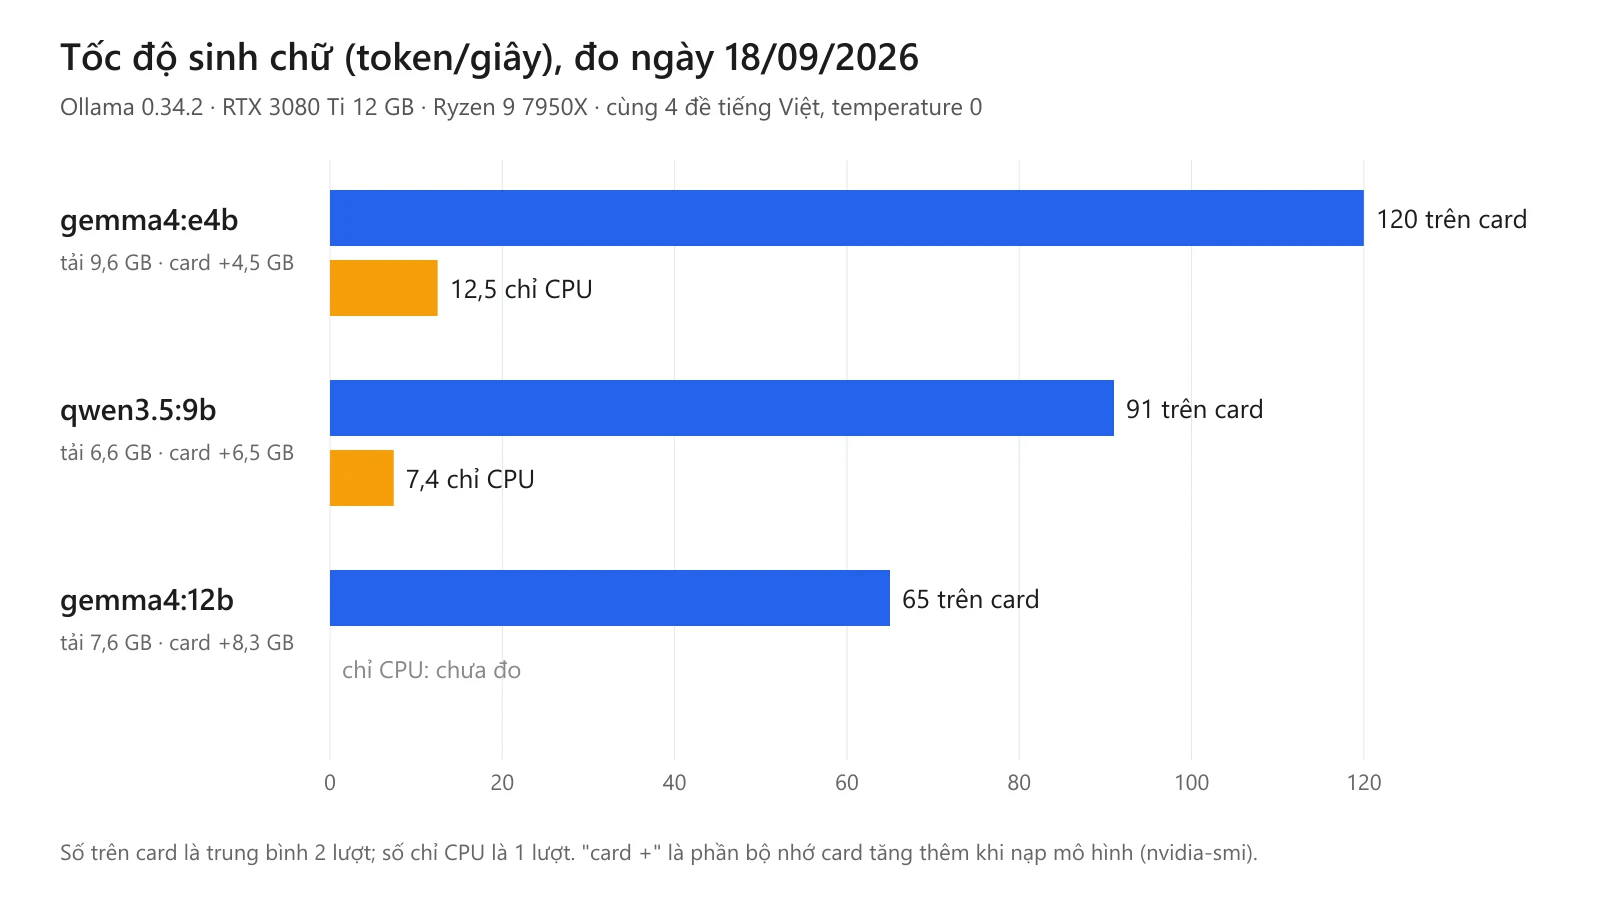
Cách đo: gọi API của Ollama với temperature 0 và tắt chế độ suy nghĩ, mỗi mô hình làm cùng bốn đề tiếng Việt, chạy hai lượt. Hai lượt cho số gần như giống hệt nhau:
- gemma4:e4b: 116 đến 124 token mỗi giây.
- qwen3.5:9b: 90 đến 92 token mỗi giây.
- gemma4:12b: 65 đến 67 token mỗi giây.
- Chỉ CPU trên Ryzen 9 7950X: gemma4:e4b khoảng 12,5, qwen3.5:9b khoảng 7,4. Đoạn giới thiệu 80 chữ mất 8,8 giây và 13,4 giây, so với 1 đến 2 giây trên card.
Nạp mô hình lên card mất 3,4 đến 4,5 giây khi tệp đã nằm sẵn trong bộ nhớ đệm của Windows. Lần đầu tiên chạy gemma4:e4b ngay sau khi tải (lúc máy đang tải mô hình khác), riêng bước nạp đã mất 36 giây và câu trả lời đầu mất thêm 34 giây.
Bạn tự đo trên máy mình bằng đoạn PowerShell sau. Mình lưu thành tệp UTF-8 có BOM và chạy được trên cả PowerShell 7 lẫn Windows PowerShell 5.1:
[Console]::OutputEncoding = [System.Text.Encoding]::UTF8
$body = @{
  model    = "gemma4:e4b"
  messages = @(@{ role = "user"; content = "Viết một đoạn giới thiệu khoảng 80 chữ cho quán cà phê nhỏ tên Mây Chiều ở Đà Lạt." })
  stream   = $false
  think    = $false
} | ConvertTo-Json -Depth 5
$r = Invoke-RestMethod -Uri "http://127.0.0.1:11434/api/chat" -Method Post -ContentType "application/json" -Body ([System.Text.Encoding]::UTF8.GetBytes($body))
$r.message.content
"{0:N1} token/giây" -f ($r.eval_count / ($r.eval_duration / 1e9))
Lần mình chạy thiếu dòng đầu, chữ có dấu trong phần trả lời bị vỡ thành dấu hỏi và ký tự lạ, dù mô hình vẫn nhận đúng đề.
Model AI local tiếng Việt: bốn đề, ba mô hình
Mình giao cùng bốn việc cho cả ba mô hình.
Viết đoạn giới thiệu khoảng 80 chữ cho quán cà phê Mây Chiều ở Đà Lạt, giọng thân thiện, không dùng biểu tượng cảm xúc:
- gemma4:e4b: đúng 80 chữ, câu văn trôi chảy, không lỗi chính tả.
- qwen3.5:9b: 75 chữ, nhưng có một cụm chữ Hán nằm giữa câu: "giúp bạn tìm thấy片刻 thư giãn". 片刻 nghĩa là "chốc lát". Nếu đăng thẳng lên fanpage, khách sẽ thấy ngay.
- gemma4:12b: 98 chữ, dài hơn yêu cầu, không lỗi chính tả.
Tóm tắt chính sách đổi trả thành đúng 3 gạch đầu dòng, giữ mọi con số (7 ngày, 30%, 3 ngày làm việc): cả ba đều làm đúng.
Giải thích câu "nước chảy đá mòn" trong 2 câu: cả ba đều đúng nghĩa kiên trì thì sẽ thành công.
Phép tính: cả ba sai khi được bảo trả lời ngắn
Đề bài: quán bán 3 ly cà phê 25.000đ một ly và 2 ổ bánh mì 20.000đ một ổ, khách đưa 200.000đ, hỏi thối lại bao nhiêu, "trả lời ngắn". Đáp án đúng là 85.000đ.
- gemma4:e4b: "Quán phải thối lại 10.000đ." Không giải thích gì thêm.
- qwen3.5:9b: dòng đầu ghi 150.000đ. Phần giải thích bên dưới lại tính ra 85.000đ, rồi thêm một ghi chú tự mâu thuẫn.
- gemma4:12b: dòng đầu ghi 10.000đ, phần giải thích ra 85.000đ, cuối bài tự "đính chính" thành 85.000đ.
Người đọc lướt chỉ nhìn dòng đầu thì cả ba lần đều nhận con số sai. Mình thử hai cách sửa, và cả hai đều cho cả ba mô hình ra đúng 85.000đ ở lần thử này:
- Bật chế độ suy nghĩ (
think: truetrong API): mất 7,9 đến 9,3 giây mỗi câu. - Giữ tắt suy nghĩ, đổi đề để mô hình tính trước rồi mới kết luận: mất 2,6 đến 3,4 giây.
Đề đã đổi ở cách 2:
Quán bán 3 ly cà phê sữa giá 25.000đ một ly và 2 ổ bánh mì giá 20.000đ một ổ. Khách đưa 200.000đ. Quán phải thối lại bao nhiêu? Tính từng bước trước, dòng cuối ghi "Đáp án: ..."Với việc liên quan tới tiền, cách an toàn hơn cả là đừng để mô hình tự tính: cho nó gọi công cụ tính toán, hoặc tự kiểm lại con số trước khi gửi cho khách.
Chọn mô hình để chạy AI trên máy tính cá nhân
Dựa trên những gì đo được với card 12 GB:
- gemma4:e4b nhanh nhất, chiếm ít bộ nhớ card nhất, và viết tiếng Việt sạch trong lần thử. Đổi lại, nó tải về nặng nhất.
- qwen3.5:9b ở giữa về tốc độ, nhưng câu chữ nó viết ra cần được đọc lại vì có thể lẫn chữ Hán.
- gemma4:12b chậm nhất và gần lấp đầy card 12 GB, còn rất ít chỗ cho ứng dụng khác.
- Máy không có card rời vẫn chạy được, nhưng mỗi đoạn văn ngắn mất cỡ 10 giây, và đó là trên một CPU desktop mạnh.
Nếu bạn cần AI tạo ảnh chứ không phải tạo chữ, cách làm tương tự nằm ở bài tạo ảnh bằng AI miễn phí trên máy tính với SDXL. Với giọng đọc tiếng Việt, xem bài chuyển văn bản thành giọng nói bằng Piper.
Những gì mình chưa kiểm
- Laptop, card NVIDIA ít bộ nhớ hơn, card AMD và máy Mac.
- LM Studio, Jan và các giao diện đồ hoạ khác.
- Mô hình lớn hơn bộ nhớ card, phải chia phần sang RAM.
- Đọc ảnh, âm thanh và tài liệu dài, dù gemma4:e4b có ghi hỗ trợ.
- Tác giả
- Quản trị viên
- Đăng ngày
- 2026-09-18
- Cập nhật
- 2026-09-18
- Thời gian đọc
- 8 phút đọc
- Tất cả bài viết