Kỹ thuật âm thanh · 8 phút đọc · 2026-09-17
Chuyển văn bản thành giọng nói miễn phí bằng Piper trên máy
Piper chạy trên máy, không cần tài khoản: đoạn 86 từ ra giọng đọc sau 429 ms. Nhưng trong ba giọng tiếng Việt chỉ vais1000 phân biệt đủ 6 thanh, số tiền cần viết bằng chữ, và mỗi giọng có giấy phép riêng.
Cần giọng đọc cho video hướng dẫn, thông báo trong cửa hàng hay bản nháp podcast, bạn có thể chuyển văn bản thành giọng nói miễn phí mà không phụ thuộc trang web nào. Mình thử Piper, bộ đọc văn bản mã nguồn mở chạy ngay trên máy tính, không cần tài khoản và không cần khoá API. Mô hình giọng là một tệp .onnx bạn tải về một lần. Khác với các công cụ chuyển văn bản thành giọng nói online, văn bản của bạn không phải gửi đi đâu cả.
Bài này ghi lại những gì đo được ngày 17/09/2026 trên Windows 11, CPU AMD Ryzen 9 7950X, không dùng GPU:
- Cài xong trong 52 giây. Một đoạn văn 86 từ ra 18,65 giây giọng đọc sau 429 ms.
- Trong ba giọng tiếng Việt có sẵn, chỉ vais1000 phân biệt đủ 6 thanh ở đầu vào. Hai giọng còn lại gộp "ma, mả, mã, mạ" thành một.
- Số tiền và ngày tháng viết bằng chữ số bị đọc lệch, ví dụ "25.000" thành "hai mươi lăm ngàn không trăm".
- Mỗi giọng có giấy phép riêng. Một giọng cấm dùng thương mại, một giọng không rõ giấy phép.
Mình không chấm độ tự nhiên bằng tai trong bài. Các so sánh về cách đọc làm ở tầng phiên âm mà Piper đưa vào mô hình, nói rõ ở phần dưới.
Cài Piper để chuyển văn bản thành giọng nói miễn phí trên Windows
Piper phát hành trên PyPI với tên piper-tts. Bản 1.8.0 ra ngày 04/09/2026, giấy phép GPL-3.0-or-later, có sẵn gói cho Windows 64-bit. Mình dùng Python 3.12, cài trong một môi trường ảo riêng:
py -3.12 -m venv piper-venv
.\piper-venv\Scripts\python.exe -m pip install piper-tts==1.8.0
Lệnh cài chạy 52 giây, kéo theo onnxruntime 1.30.0 và numpy 2.5.3. Xong bước này khi lệnh .\piper-venv\Scripts\python.exe -m piper --help in ra danh sách tuỳ chọn.
Chọn giọng tiếng Việt: kiểm giấy phép và thanh điệu
Muốn chuyển văn bản thành giọng nói tiếng Việt cho ổn, chọn giọng quan trọng hơn mọi tuỳ chọn khác. Kho giọng chính thức nằm ở rhasspy/piper-voices trên Hugging Face. Thư mục tiếng Việt vi/vi_VN nặng 158 MB, gồm ba giọng.
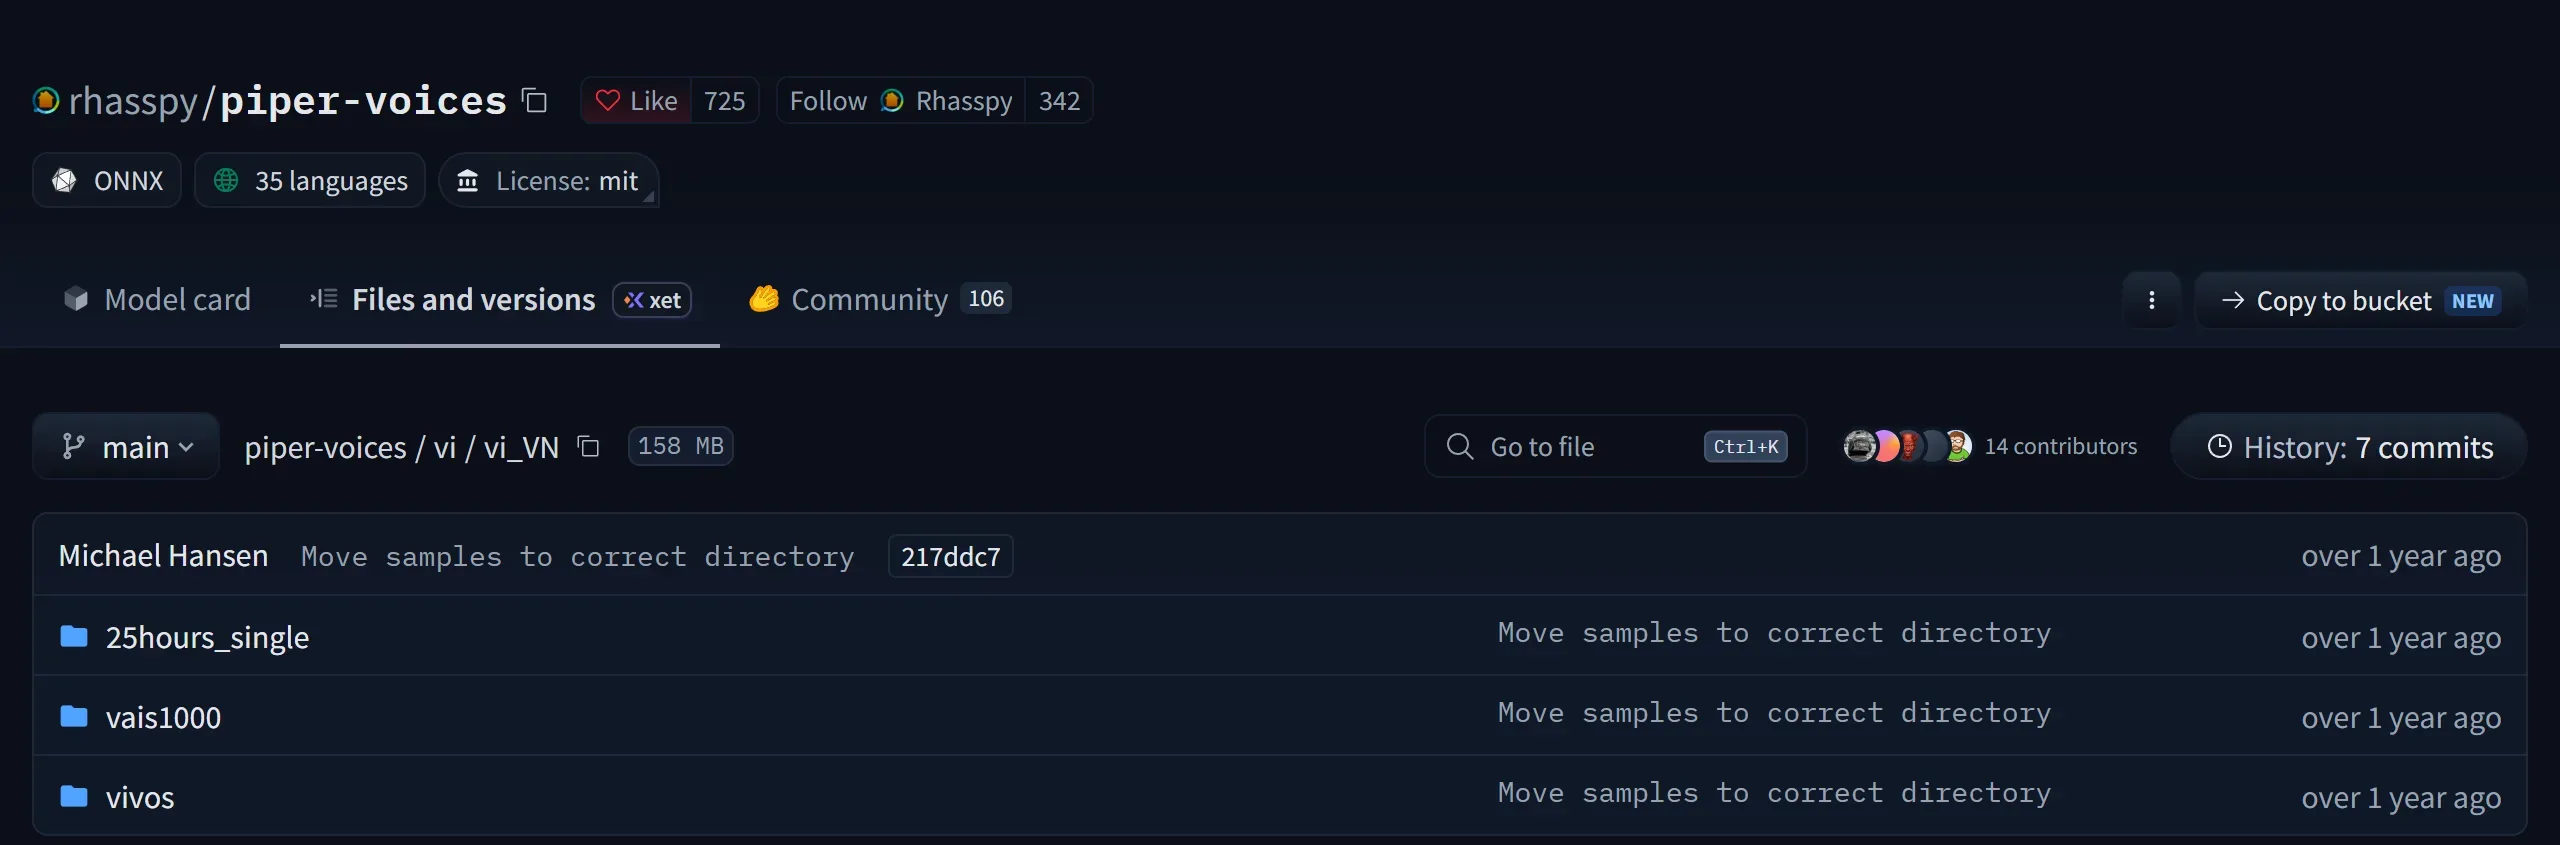
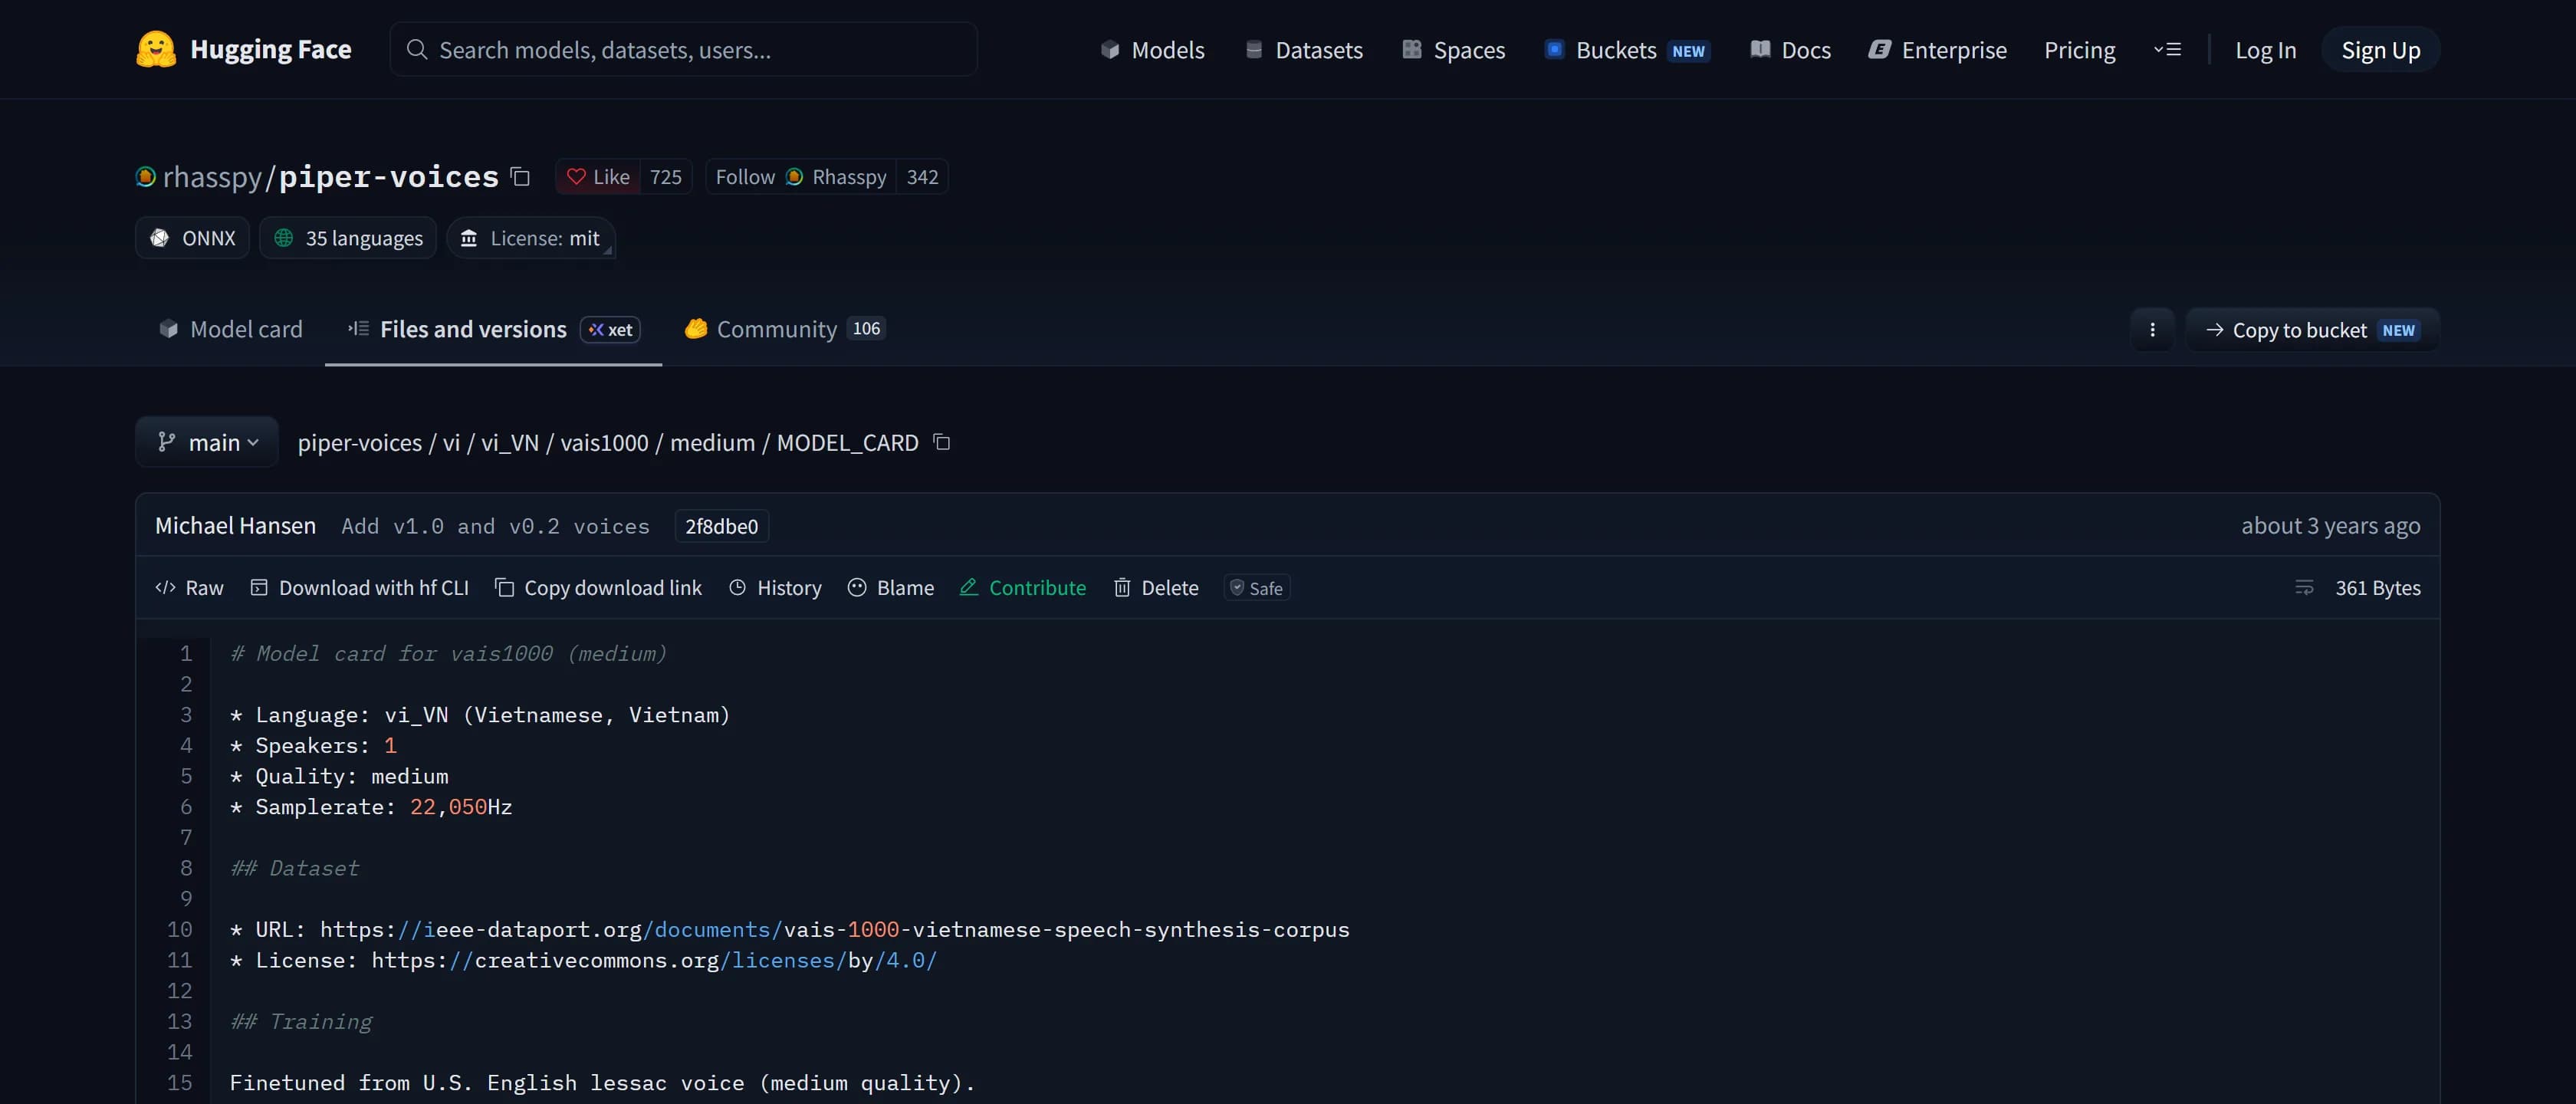
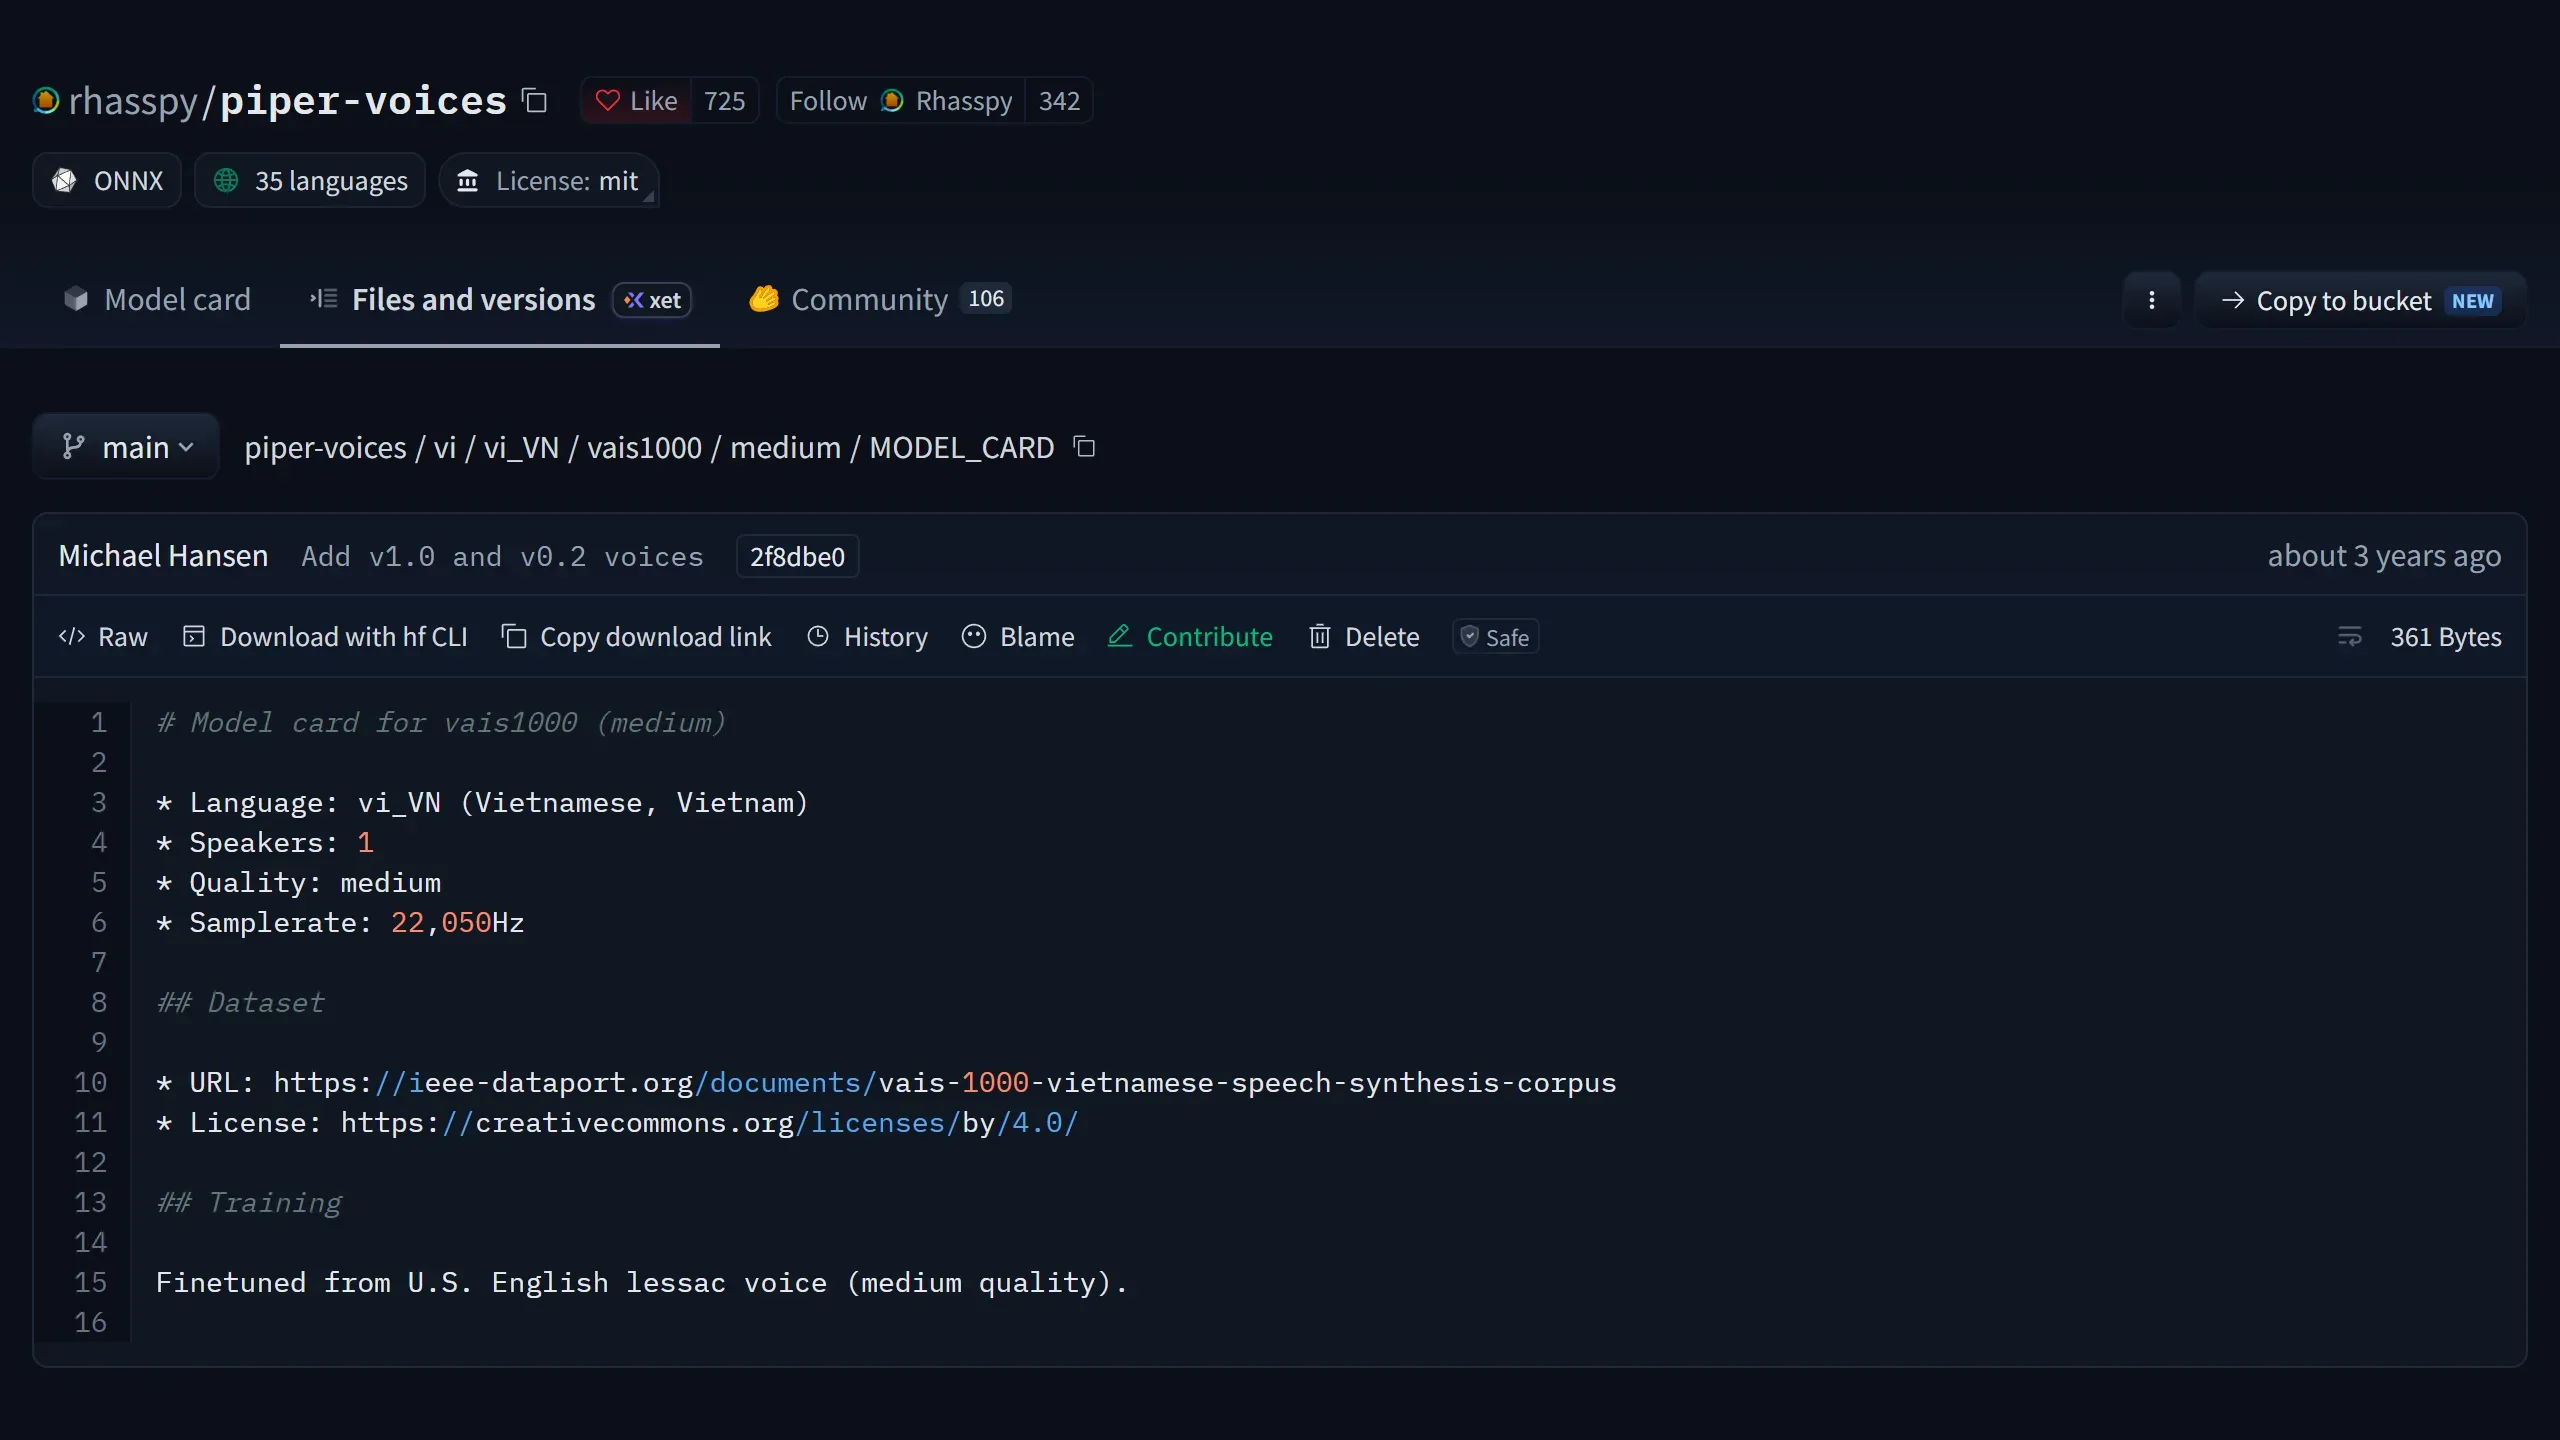
Đầu trang repo có nhãn "License: mit", nhưng đừng dừng ở nhãn đó. Mỗi giọng có tệp MODEL_CARD ghi giấy phép của bộ dữ liệu dùng để huấn luyện:
- vi_VN-vais1000-medium: 1 giọng, 22.050 Hz, tệp 63 MB. Bộ dữ liệu VAIS-1000, giấy phép CC BY 4.0, tức được dùng thương mại nếu ghi công.
- vi_VN-25hours_single-low: 1 giọng, 16.000 Hz, 63 MB. Giấy phép ghi Unknown.
- vi_VN-vivos-x_low: 65 giọng, 16.000 Hz, 28 MB. Bộ dữ liệu VIVOS, giấy phép CC BY-NC-SA 4.0, chữ NC nghĩa là phi thương mại.
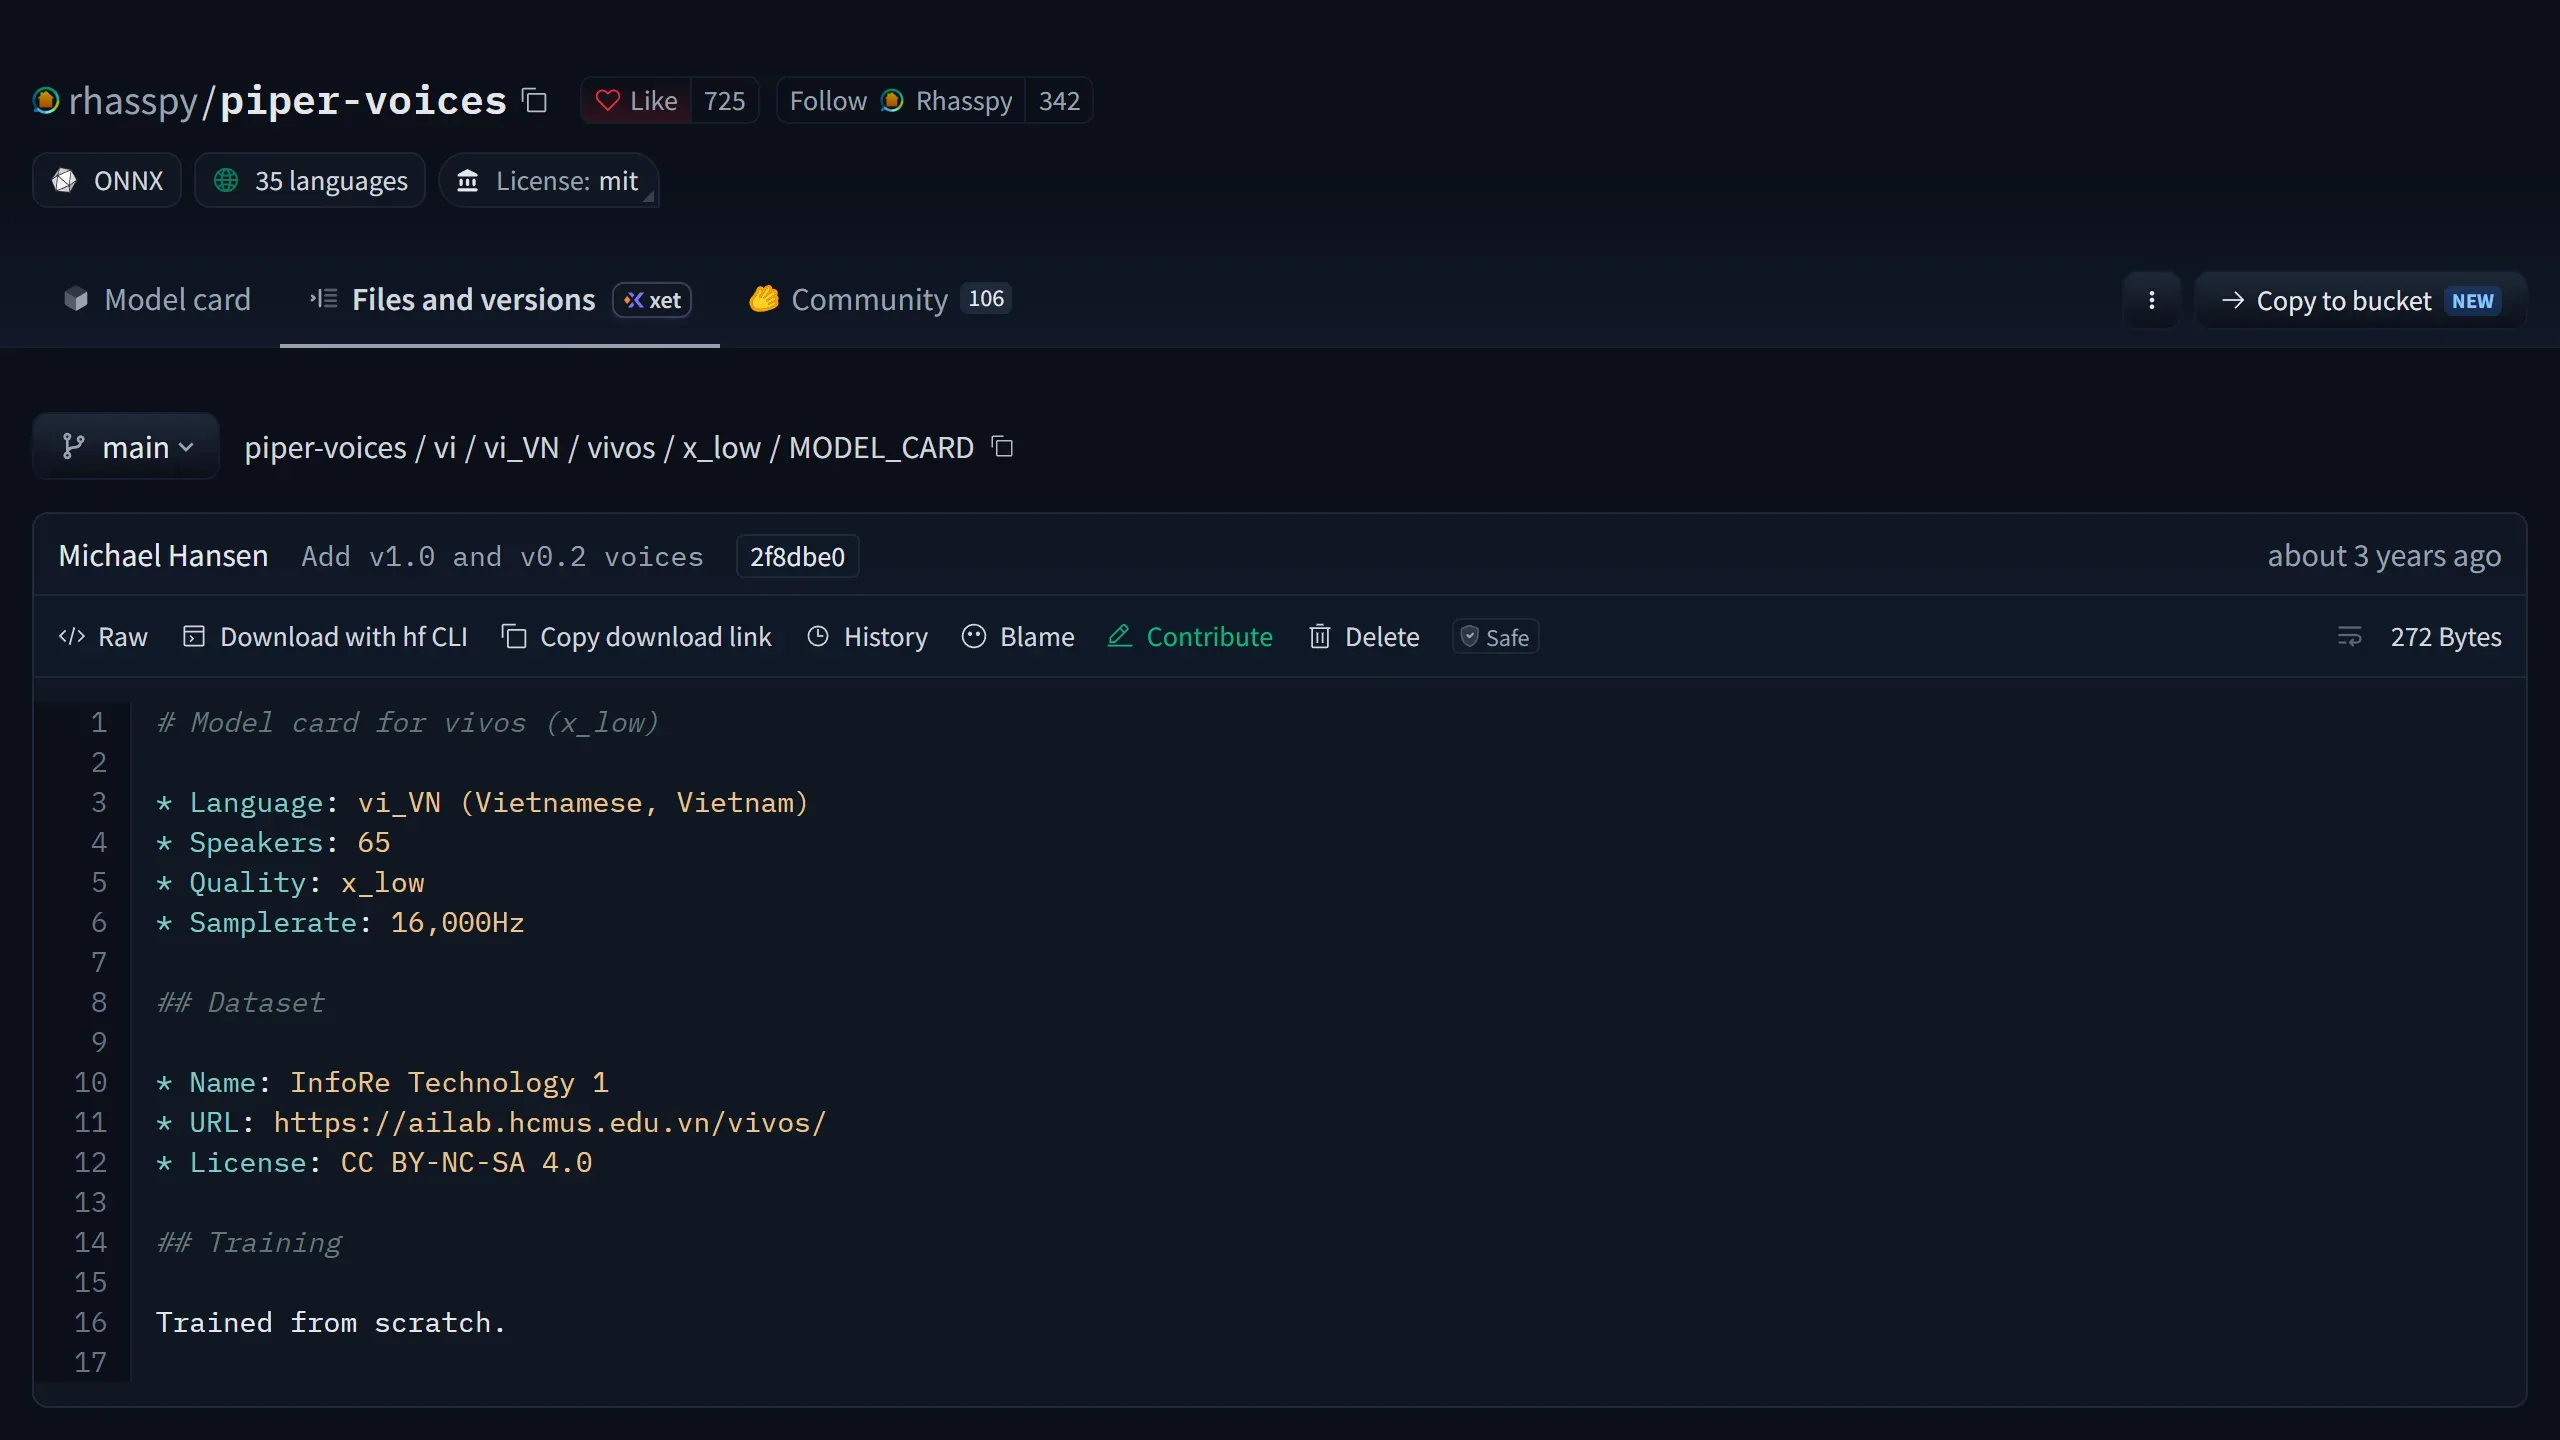
Nếu giọng đọc dùng cho video bán hàng hay quảng cáo, vivos không hợp về giấy phép, còn 25hours_single thì chưa rõ. Đây là cách mình đọc model card; muốn chắc cho trường hợp cụ thể, bạn nên đọc thẳng điều khoản của bộ dữ liệu.
Thanh điệu: chỉ vais1000 phân biệt đủ
Khi tổng hợp bằng hai giọng 25hours_single và vivos, Piper in ra cảnh báo "Missing phoneme from id map". Mình lần theo và thấy: với piper-tts 1.8.0, phiên âm tiếng Việt dùng các ký hiệu 2, 4, 5, 6 để đánh dấu thanh, nhưng bảng ký hiệu của hai giọng này không có bốn ký hiệu đó. Piper bỏ qua chúng.
Để thấy hậu quả, mình cho cả ba giọng phiên âm sáu từ "ma, má, mà, mả, mã, mạ" rồi so dãy mã đưa vào mô hình:
- vais1000: 6 dãy mã khác nhau cho 6 từ.
- 25hours_single: chỉ 3 dãy. "ma, mả, mã, mạ" ra cùng một dãy.
- vivos: cũng 3 dãy, gộp y hệt.
Mô hình nhận đầu vào giống hệt nhau thì không thể đọc bốn từ đó khác nhau. Với tiếng Việt, đây là lý do đủ để chọn vais1000.
Tải giọng vais1000, cần đủ hai tệp .onnx và .onnx.json (trên máy thử hết 3 giây):
mkdir giong
curl.exe -L -o giong\vi_VN-vais1000-medium.onnx https://huggingface.co/rhasspy/piper-voices/resolve/main/vi/vi_VN/vais1000/medium/vi_VN-vais1000-medium.onnx
curl.exe -L -o giong\vi_VN-vais1000-medium.onnx.json https://huggingface.co/rhasspy/piper-voices/resolve/main/vi/vi_VN/vais1000/medium/vi_VN-vais1000-medium.onnx.json
Đọc thử câu đầu tiên
Lưu văn bản vào tệp cau.txt dạng UTF-8, rồi chạy:
.\piper-venv\Scripts\python.exe -m piper -m giong\vi_VN-vais1000-medium.onnx -i cau.txt -f ra.wavTệp ra.wav là WAV mono 16 bit, 22.050 Hz. Piper chỉ xuất WAV; nếu bạn cần chuyển văn bản thành MP3, phải thêm một bước đổi định dạng mà mình chưa thử trong bài. Mỗi lệnh như vậy mất 1,6 đến 2,3 giây trên máy thử, phần lớn là thời gian nạp mô hình. Tệp văn bản lưu kèm BOM (kiểu PowerShell 5 hay một số trình soạn thảo hay thêm) vẫn đọc bình thường.
Các tuỳ chọn hay dùng: --length-scale (tốc độ đọc), --sentence-silence (khoảng lặng sau mỗi câu), --volume và --no-normalize. Riêng --length-scale, đặt 1.2 thay vì 1.0 chỉ làm đoạn thử dài thêm khoảng 6% (18,65 giây lên 19,73 giây), ít hơn nhiều so với con số 20% mà cái tên gợi ý.
Đọc nhiều tệp một lần bằng Python
Khi cần đọc cả chục đoạn, nạp mô hình một lần rồi đọc lần lượt sẽ nhanh hơn gọi lệnh nhiều lần. Đặt các tệp .txt vào thư mục van-ban, tạo thư mục giong-doc, rồi lưu script này thành doc-van-ban.py:
import wave
from pathlib import Path
from piper import PiperVoice, SynthesisConfig

voice = PiperVoice.load("giong/vi_VN-vais1000-medium.onnx")
cfg = SynthesisConfig(length_scale=1.0)

for tep in sorted(Path("van-ban").glob("*.txt")):
    text = tep.read_text(encoding="utf-8-sig").strip()
    ra = Path("giong-doc") / (tep.stem + ".wav")
    with wave.open(str(ra), "wb") as w:
        voice.synthesize_wav(text, w, syn_config=cfg)
print(ra, ra.stat().st_size, "byte").\piper-venv\Scripts\python.exe doc-van-ban.pyĐo trên đoạn thông báo 86 từ, lấy kết quả tốt nhất trong 3 lần:
- vais1000 medium: 429 ms, ra 18,65 giây âm thanh, tức nhanh gấp khoảng 43 lần thời gian thực.
- 25hours_single low: 390 ms, ra 23,82 giây.
- vivos x_low: 363 ms, ra 26,58 giây.
Nạp mỗi mô hình mất khoảng 1,15 giây. Với CPU này, tốc độ không phải lý do để chọn giọng chất lượng thấp. Nếu bạn cần chuyển văn bản thành giọng nói miễn phí cho cả loạt video, tốc độ này đủ để không phải chờ. Chạy trên máy cũng có nghĩa là cách tạo giọng đọc AI miễn phí này không có hạn mức số lần dùng.
Viết số và ngày tháng thế nào cho Piper đọc đúng
Piper chuyển chữ thành phiên âm trước, rồi mới đưa phiên âm vào mô hình. Mình so phiên âm của cách viết bằng chữ số với phiên âm của các cách đọc bằng chữ (giọng vais1000):
- "125" thành "một trăm hai mươi lăm". Đúng.
- "8 giờ 30" thành "tám giờ ba mươi". Đúng.
- "25.000" thành "hai mươi lăm ngàn không trăm", khớp hoàn toàn. "25.000 đồng" cũng thừa "không trăm" y như vậy.
- "1.500.000" gần với "một triệu năm trăm ngàn không trăm".
- "17/09/2026" gần với "mười bảy không chín hai ngàn không trăm hai mươi sáu", mất cả chữ "tháng" lẫn "năm".
- "TP.HCM" gần với "tê pê chấm hát xê em mờ".
- "WordPress" giữ phiên âm kiểu tiếng Anh.
Cách sửa đơn giản nhất là viết sẵn bằng chữ trước khi đưa vào Piper. "ngày 17 tháng 9 năm 2026" cho phiên âm gần như trùng "ngày mười bảy tháng chín năm hai ngàn không trăm hai mươi sáu", chỉ lệch vị trí một ký hiệu thanh ở chữ cuối; "Thành phố Hồ Chí Minh" viết đầy đủ cũng đúng. Với tiền, viết "hai mươi lăm ngàn đồng" thay vì "25.000 đồng".
Lưu ý giới hạn của phép so này: nó kiểm đầu vào của mô hình, không phải bản ghi âm được nghe lại. Phiên âm sai thì giọng gần như chắc chắn đọc sai; phiên âm đúng thì giọng vẫn có thể đọc chưa tròn.
Độ lớn của giọng đọc Piper
Nếu bạn ghép giọng đọc vào video có nhạc nền, cần biết giọng ra to cỡ nào. Mình đo bằng thư viện pyloudnorm:
.\piper-venv\Scripts\python.exe -m pip install pyloudnorm==0.1.1 soundfileimport sys
import numpy as np
import soundfile as sf
import pyloudnorm as pyln
x, sr = sf.read(sys.argv[1])
lufs = pyln.Meter(sr).integrated_loudness(x)
dinh = 20 * np.log10(np.max(np.abs(x)))
print(f"{lufs:.1f} LUFS, đỉnh {dinh:.1f} dBFS")Lưu thành do-lufs.py, chạy .\piper-venv\Scripts\python.exe do-lufs.py giong-doc\ten-tep.wav. Kết quả trên máy thử (đặt các tham số qua SynthesisConfig trong script):
- Mặc định: đoạn 86 từ ra −16,4 LUFS, đỉnh 0,0 dBFS. Piper chuẩn hoá cho đỉnh chạm trần. Một câu ngắn đo được −14,5 LUFS, nên độ lớn còn tuỳ nội dung.
- `volume=0.5` (dòng lệnh là
--volume 0.5): −22,5 LUFS, đỉnh −6,0 dBFS. - `normalize_audio=False` (dòng lệnh là
--no-normalize): −18,8 LUFS, đỉnh −1,3 dBFS.
Ở cả ba cách, đỉnh luôn cao hơn độ lớn trung bình khoảng 16 đến 17,6 dB. Hệ quả: kéo thẳng đoạn mặc định lên −16 LUFS thì đỉnh vượt 0 dBFS thêm 0,4 dB, còn lên −14 LUFS thì vượt 2,4 dB. Phần vượt sẽ bị cắt méo khi lưu. Muốn to hơn mức mặc định mà không méo, cần bộ nén hoặc limiter; mình chưa thử bước này.
Khi ghép với nhạc nền, cách an toàn hơn là giữ giọng như Piper xuất ra và hạ nhạc xuống, thay vì đẩy giọng lên.
Những gì mình chưa kiểm
- Nghe và chấm độ tự nhiên của từng giọng.
- Rút mạng hoàn toàn khi chạy, chạy bằng GPU với
--cuda, chạy trên Linux hay Raspberry Pi. - Các giọng khác nhau trong 65 giọng của vivos.
- Nén, limiter và xuất MP3.
- Tác giả
- Quản trị viên
- Đăng ngày
- 2026-09-17
- Cập nhật
- 2026-09-17
- Thời gian đọc
- 8 phút đọc
- Tất cả hướng dẫn