Kỹ thuật âm thanh · 6 phút đọc · 2026-09-17
Tách lời khỏi nhạc bằng Demucs trên máy: cài đặt, lỗi numpy, đo chất lượng GPU và CPU
Mình trộn giọng đọc với nhạc không lời để có đáp án, rồi cho Demucs tách: giọng từ 1,5 dB lên 14,7 dB SI-SDR, một bài 205 giây mất 7,5 giây trên GPU và 37 giây trên CPU. Kèm lỗi thiếu numpy khi cài trên Windows.
Muốn tách lời khỏi nhạc mà không tải bài lên trang web nào, bạn có thể chạy Demucs ngay trên máy. Đây là mô hình tách nguồn âm thanh mã nguồn mở, giấy phép MIT, tức một cách tách nhạc bằng AI hoàn toàn miễn phí. Nhưng "tách được" là câu trả lời quá dễ. Mình muốn biết tách tốt tới đâu, nên dựng một bài thử có sẵn đáp án: trộn một giọng đọc với một bản nhạc không lời, cho Demucs tách, rồi so từng phần với bản gốc.
Kết quả đo ngày 17/09/2026 trên Windows 11, Ryzen 9 7950X, RTX 3080 Ti:
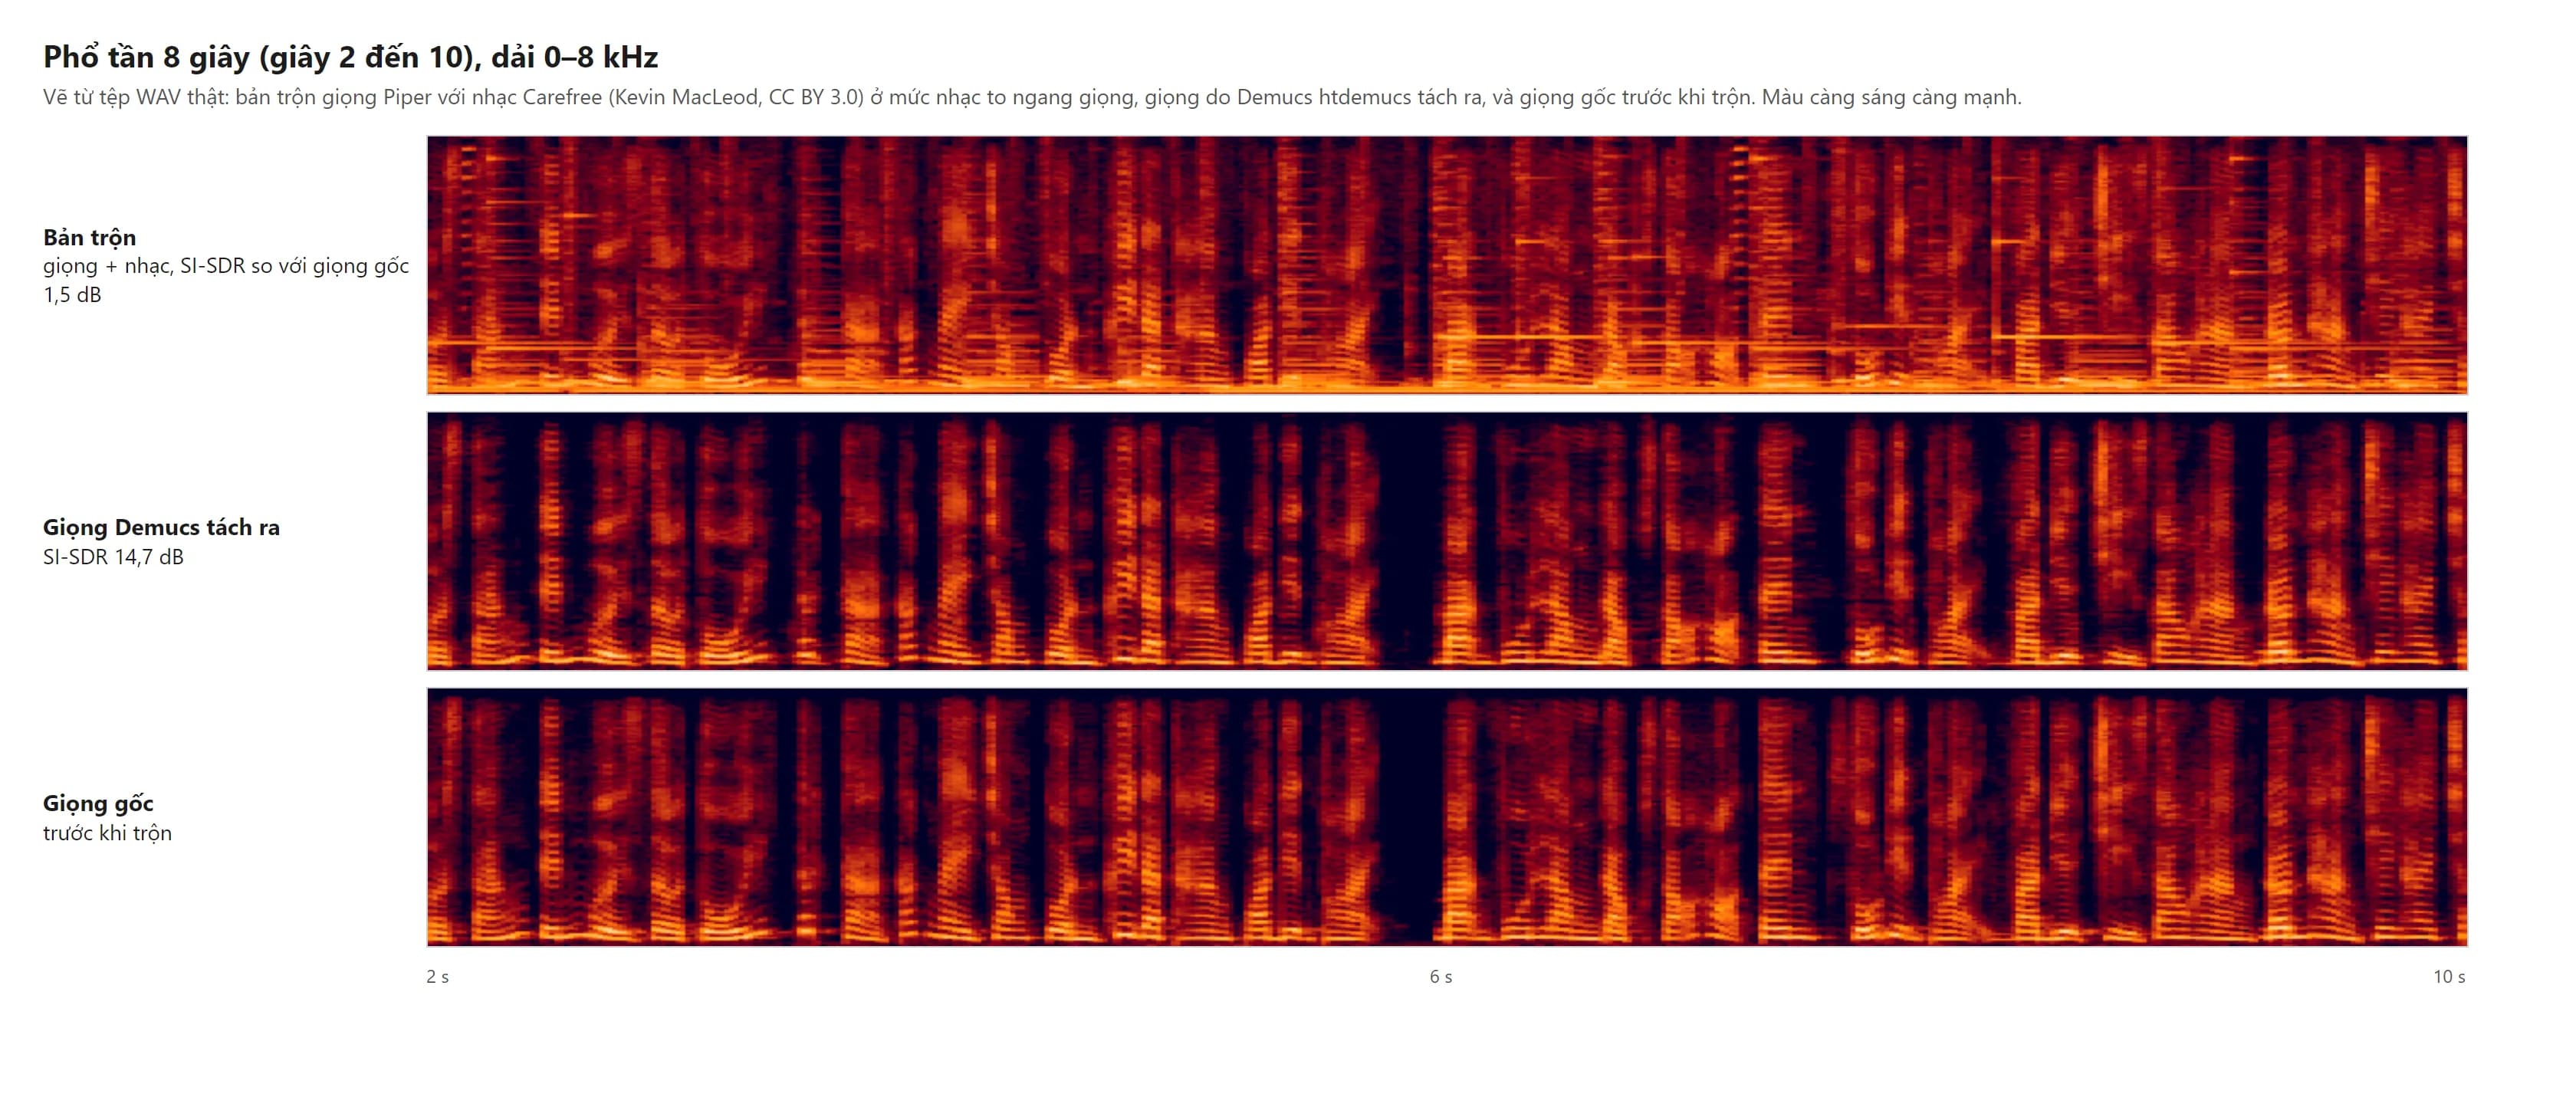
- Khi nhạc to ngang giọng, giọng tách ra đạt 14,7 dB SI-SDR so với giọng gốc, trong khi bản trộn chỉ 1,5 dB.
- Tách nguyên một bài 205 giây mất 7,5 giây trên GPU và 37 giây trên CPU. Chất lượng hai bên gần như trùng.
- Cài theo cách thông thường trên Windows sẽ vấp lỗi thiếu numpy ngay lần chạy đầu.
Lưu ý phạm vi: phép thử dùng giọng đọc chứ không phải ca sĩ hát. Nếu bạn cần tách giọng hát khỏi nhạc trong bài hát thật, hãy coi các con số dưới đây là điểm tham khảo. Kết quả với bài hát thật có thể khác; phần cuối bài ghi rõ những gì chưa kiểm.
Cài Demucs để tách lời khỏi nhạc trên Windows
Demucs 4.1.0 ra ngày 11/07/2026. Mình dùng Python 3.12 và cài bản torch có CUDA cho GPU NVIDIA:
py -3.12 -m venv demucs-venv
.\demucs-venv\Scripts\python.exe -m pip install torch --index-url https://download.pytorch.org/whl/cu128
.\demucs-venv\Scripts\python.exe -m pip install demucs==4.1.0
Cài torch mất 137 giây (bản 2.11.0+cu128), cài Demucs mất 17 giây. Kiểm GPU đã nhận chưa:
.\demucs-venv\Scripts\python.exe -c "import torch; print(torch.cuda.is_available())"Máy thử in True. Máy không có GPU NVIDIA vẫn chạy được bằng CPU (thêm -d cpu ở lệnh tách); mình chỉ cài bản CUDA nên chưa thử cài riêng bản torch cho CPU.
Lỗi thiếu numpy ngay lần chạy đầu
Gọi Demucs lần đầu, máy thử báo:
ModuleNotFoundError: No module named 'numpy'Lỗi đến từ tệp demucs/transformer.py. Demucs 4.1.0 chỉ khai báo cần numpy trên macOS chip Intel, còn torch tải từ kho của PyTorch cũng không kéo numpy về. Kết quả là môi trường ảo sạch trên Windows thiếu đúng một gói. Sửa bằng một lệnh:
.\demucs-venv\Scripts\python.exe -m pip install numpyMô hình 84 MB tải về ổ C
Lần tách đầu tiên, Demucs tải mô hình htdemucs từ Hugging Face (repo adefossez/HTDemucs), tệp nặng 84.025.440 byte. Mặc định tệp nằm trong thư mục cache Hugging Face của tài khoản Windows, tức là ổ C. Đặt biến HF_HOME trước khi chạy thì mô hình tải về chỗ bạn chọn:
$env:HF_HOME = "D:\demucs-cache"Mình đã thử cách này và thấy tệp 84 MB nằm đúng trong thư mục mới. Biến TORCH_HOME thì không có tác dụng với mô hình này.
Tách nhạc và lời bằng một lệnh
.\demucs-venv\Scripts\python.exe -m demucs --two-stems=vocals -n htdemucs -o tach bai-hat.wavTuỳ chọn --two-stems=vocals chỉ tách hai phần, đúng nhu cầu tách vocal thường gặp. Kết quả nằm trong tach\htdemucs\bai-hat\:
vocals.wav: phần giọng.no_vocals.wav: phần còn lại. Muốn tách nhạc nền thì đây là tệp bạn cần.
Cả hai là WAV 16 bit, 44.100 Hz, stereo. Thêm --mp3 để xuất MP3; với đoạn thử 19,65 giây, mỗi tệp MP3 nặng 787.853 byte. Thêm -d cpu nếu muốn ép chạy CPU.
Bài thử có đáp án: giọng Piper trộn với nhạc Carefree
Để chấm điểm được, cần biết trước giọng và nhạc gốc trông ra sao. Mình dựng bài thử như sau:
- Giọng: đoạn thông báo 86 từ, đọc bằng Piper với giọng vais1000 (cách tạo ở bài chuyển văn bản thành giọng nói miễn phí). Đổi lên 44.100 Hz stereo, thêm nửa giây lặng ở hai đầu, tổng 19,65 giây.
- Nhạc: "Carefree" của Kevin MacLeod, lấy đoạn bắt đầu từ giây 20.
- Hai mức trộn: nhạc nhỏ hơn giọng 12 LU, và nhạc to ngang giọng.
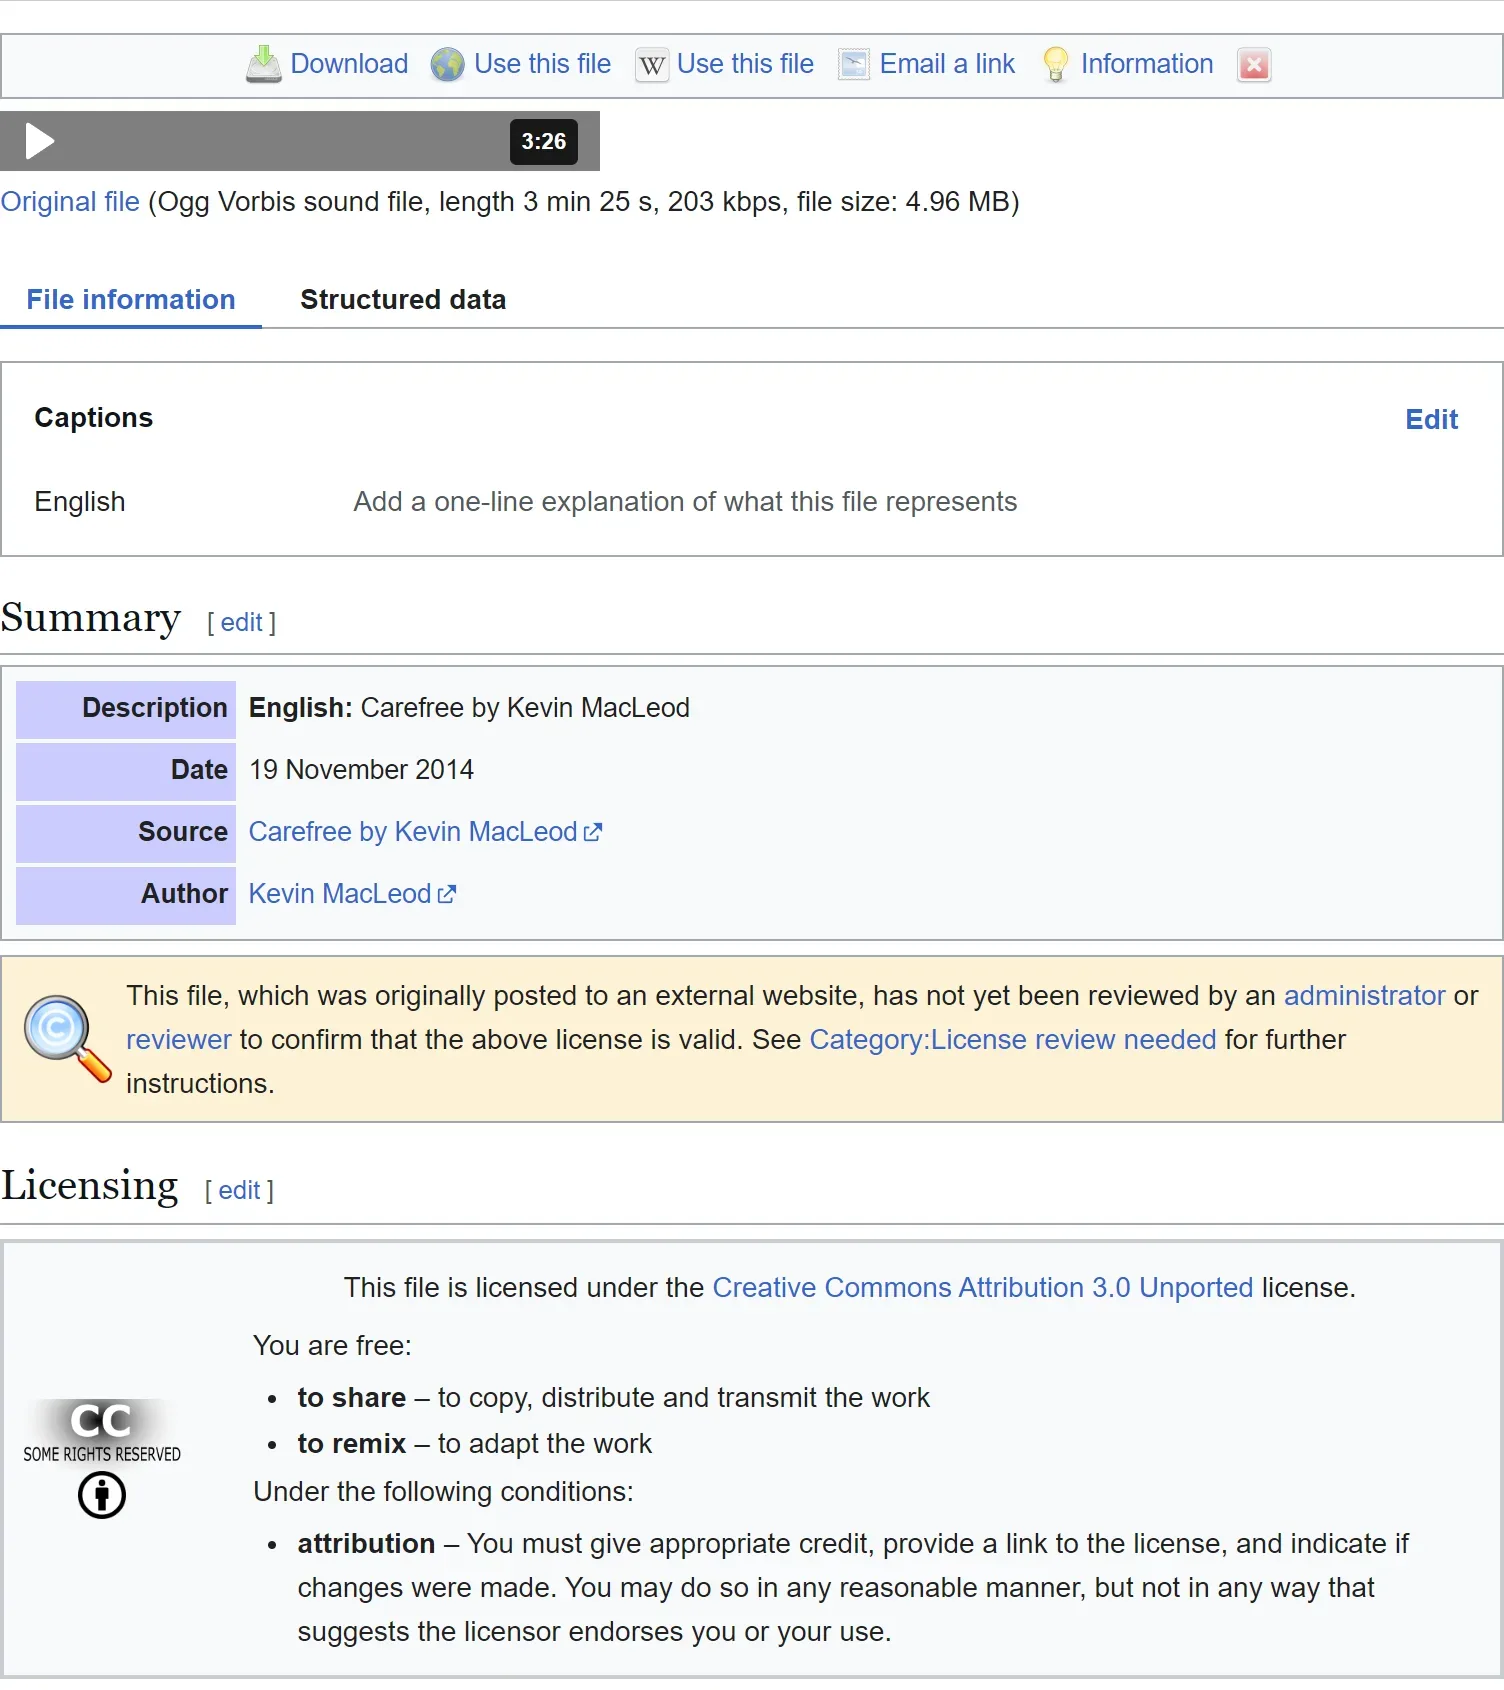
Bản nhạc tải từ Wikimedia Commons. Trang tệp ghi giấy phép Creative Commons Attribution 3.0 và nguồn Free Music Archive, nhưng cũng có khung vàng cho biết giấy phép chưa được quản trị viên xác nhận.
Thước đo là SI-SDR, tính bằng dB: so tín hiệu tách ra với tín hiệu gốc, càng cao càng giống. Để có mốc, mình tính luôn SI-SDR của bản trộn chưa tách so với giọng gốc.
Kết quả: tách lời khỏi nhạc được tới đâu
Nhạc nhỏ hơn giọng 12 LU (kiểu video có giọng thuyết minh):
- Bản trộn so với giọng gốc: 13,6 dB.
- Giọng Demucs tách ra: 22,6 dB trên GPU, 22,7 dB trên CPU.
- Nhạc tách ra: 8,5 dB, từ mức −14,0 dB của bản trộn.
Nhạc to ngang giọng, trường hợp khó hơn:
- Bản trộn so với giọng gốc: 1,5 dB.
- Giọng tách ra: 14,7 dB trên GPU, 14,5 dB trên CPU.
- Nhạc tách ra: 13,0 dB trên GPU, 12,8 dB trên CPU, từ −1,7 dB.
GPU và CPU cho ra gần như cùng một tệp: chênh lệch mẫu lớn nhất giữa hai bản giọng tách chỉ 0,069.
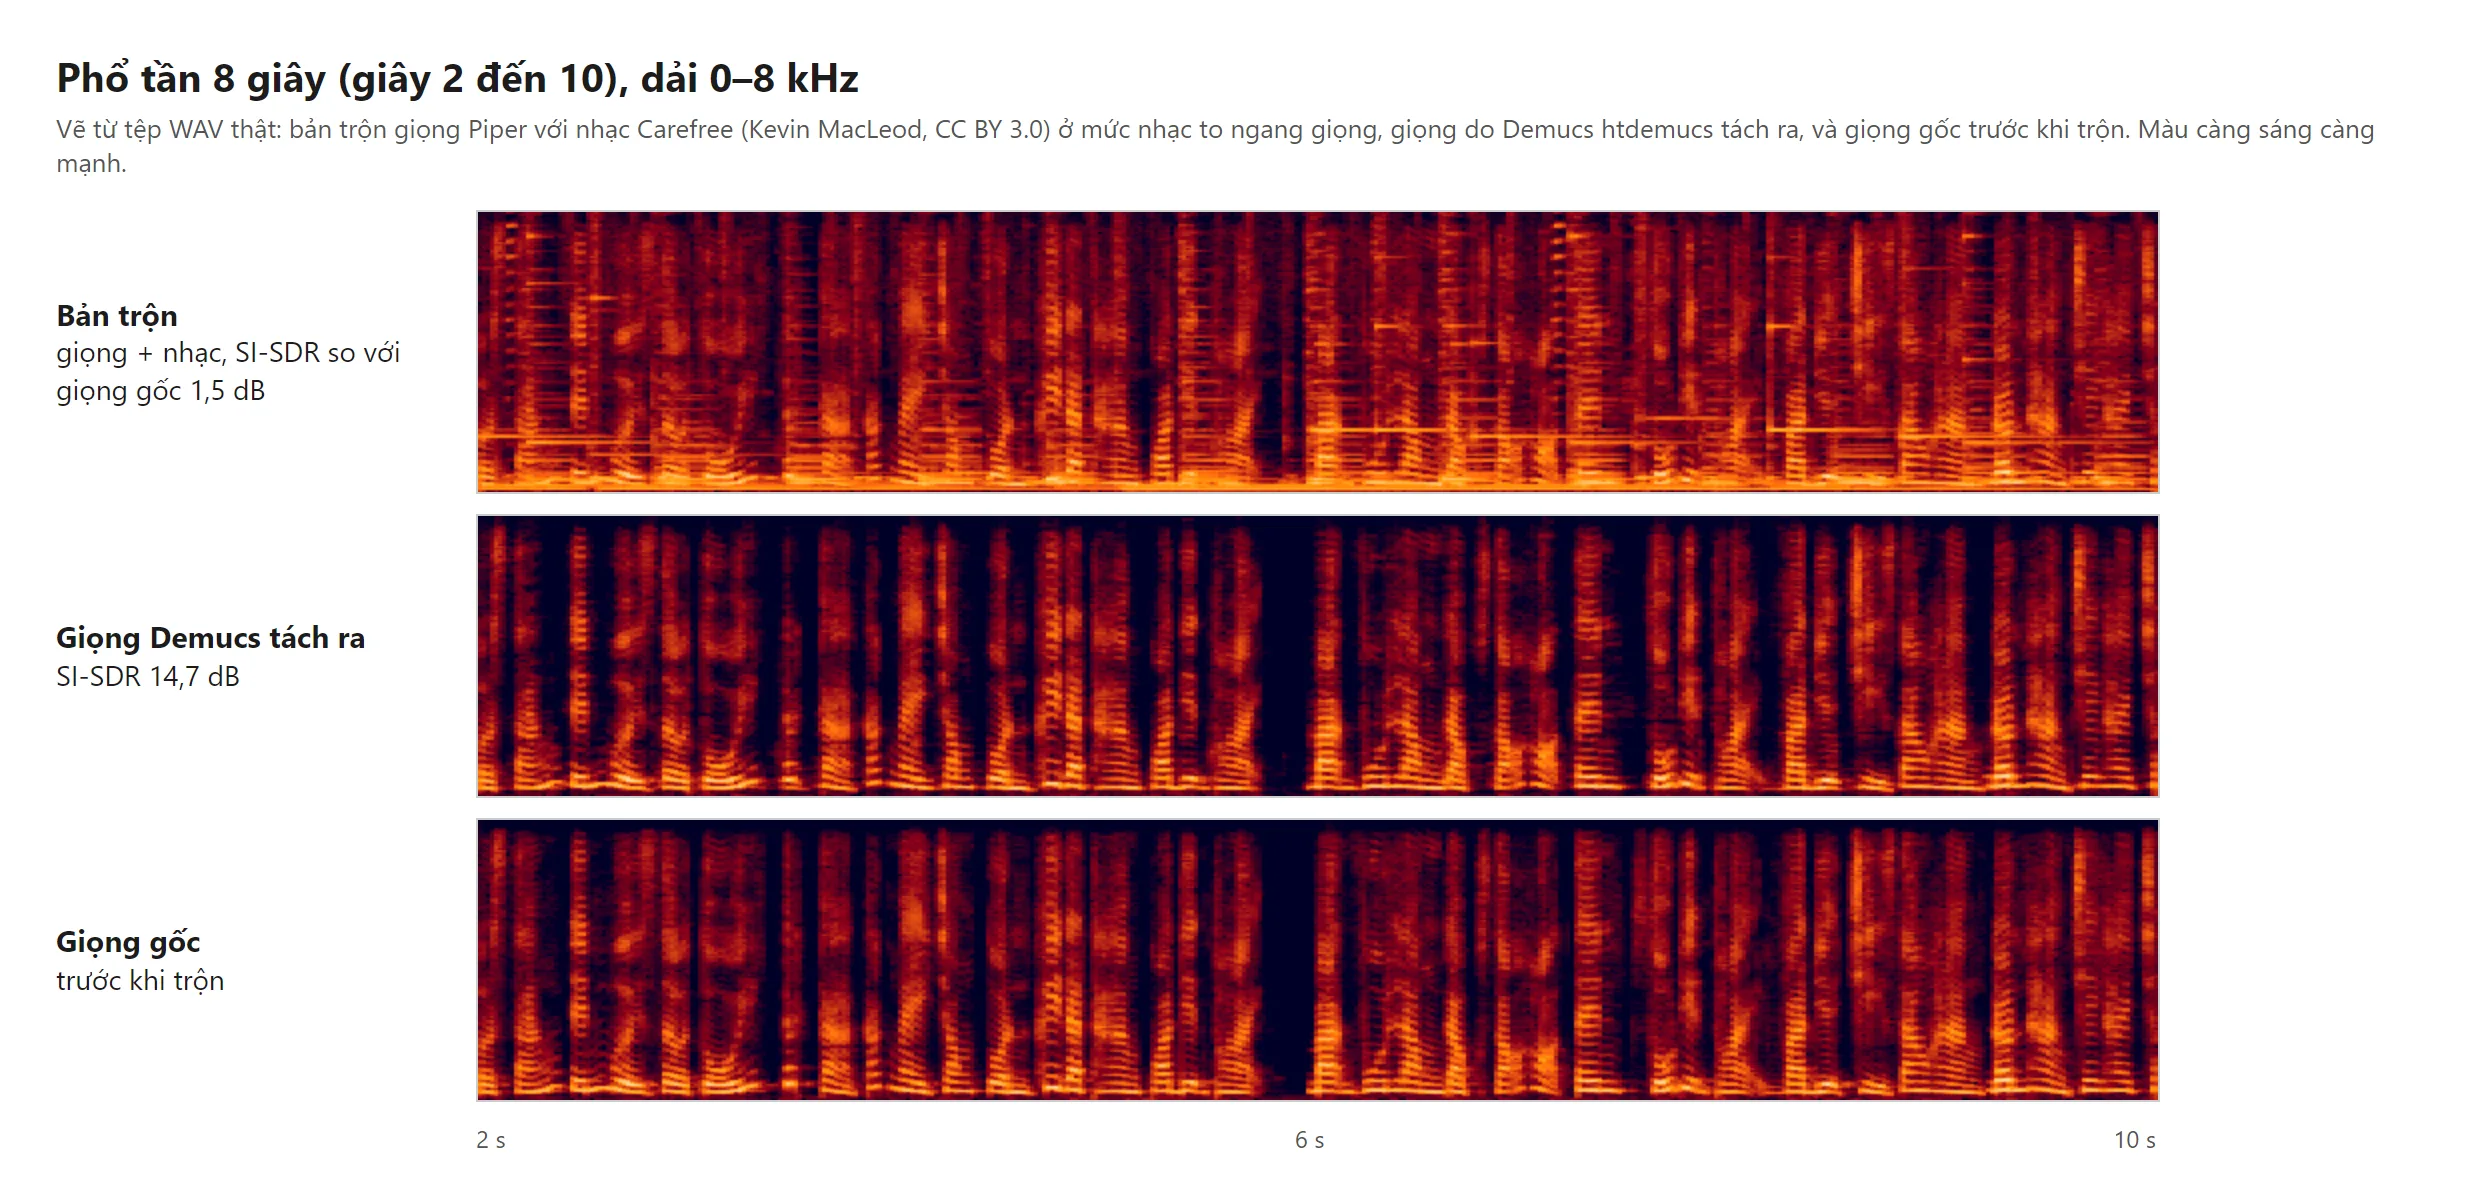
Ảnh phổ tần trên vẽ từ chính các tệp WAV. Ở bản trộn, nhạc hiện thành các vệt ngang nằm giữa những cột tiếng nói. Ở dải giọng tách ra, các vệt đó gần như biến mất và hình dạng rất gần với giọng gốc.
Nhạc không lời thì vocals.wav có im lặng không
Mình cho Demucs tách nguyên bài Carefree, vốn không có lời:
no_vocals.wav: −20,2 LUFS, bằng đúng bản gốc (−20,2 LUFS).vocals.wav: −42,1 LUFS, nhỏ hơn nhạc khoảng 22 LU, nhưng không im lặng: đỉnh vẫn lên tới −26,7 dBFS.
Nói cách khác, với nhạc không lời, Demucs vẫn nhặt ra một ít âm thanh vào phần giọng. Nếu bạn dùng vocals.wav cho việc gì đó, nhớ nghe lại những đoạn không có người nói.
Thời gian chạy
- Nguyên bài 205 giây: GPU 7.477 ms, CPU 37.081 ms.
- Đoạn 19,65 giây: GPU lần đầu 8.902 ms (gồm tải mô hình 84 MB), hai tệp liền nhau trên GPU 4.014 ms, hai tệp trên CPU 10.905 ms.
- Riêng nạp thư viện Demucs mất khoảng 1,5 giây mỗi lần gọi lệnh.
Với CPU 16 nhân của máy thử, tách một bài dài hơn ba phút mất chưa tới 40 giây. Không có GPU vẫn dùng được cho vài bài; có GPU thì nhanh gấp khoảng 5 lần.
Dùng phần tách ra: để ý giấy phép
Tách được không có nghĩa là được dùng. Nếu bạn tìm phần mềm tách nhạc và lời để lấy beat karaoke từ bài hát có sẵn, nhớ rằng phần giọng hay nhạc nền tách từ một bài hát vẫn thuộc về người giữ quyền của bài đó. Trong bài này mình dùng giọng tự tạo bằng Piper và một bản nhạc Commons ghi giấy phép CC BY 3.0, nên ghi công: "Carefree" – Kevin MacLeod, CC BY 3.0.
Những gì mình chưa kiểm
- Bài hát có ca sĩ hát thật, nhiều bè, hát tiếng Việt.
- Các mô hình khác như
htdemucs_ft, tuỳ chọn--shifts. - Tách bốn phần (trống, bass, nhạc cụ khác, giọng).
- Cài torch bản chỉ dành cho CPU.
- Tác giả
- Quản trị viên
- Đăng ngày
- 2026-09-17
- Cập nhật
- 2026-09-17
- Thời gian đọc
- 6 phút đọc
- Tất cả hướng dẫn