Tự động hoá · 9 phút đọc · 2026-09-18
Tạo AI agent miễn phí bằng n8n và Ollama trên máy: agent tư vấn bán hàng, 3 mô hình và hai cái bẫy
Mình dựng agent tư vấn bán hàng trong n8n 2.39.8, mô hình chạy bằng Ollama trên máy, rồi hỏi 10 câu có đáp án sẵn. gemma4 đúng 20/20; qwen3.5:9b trả lời rỗng 3/30 câu khi để suy nghĩ; credential localhost không kết nối được trên Windows.
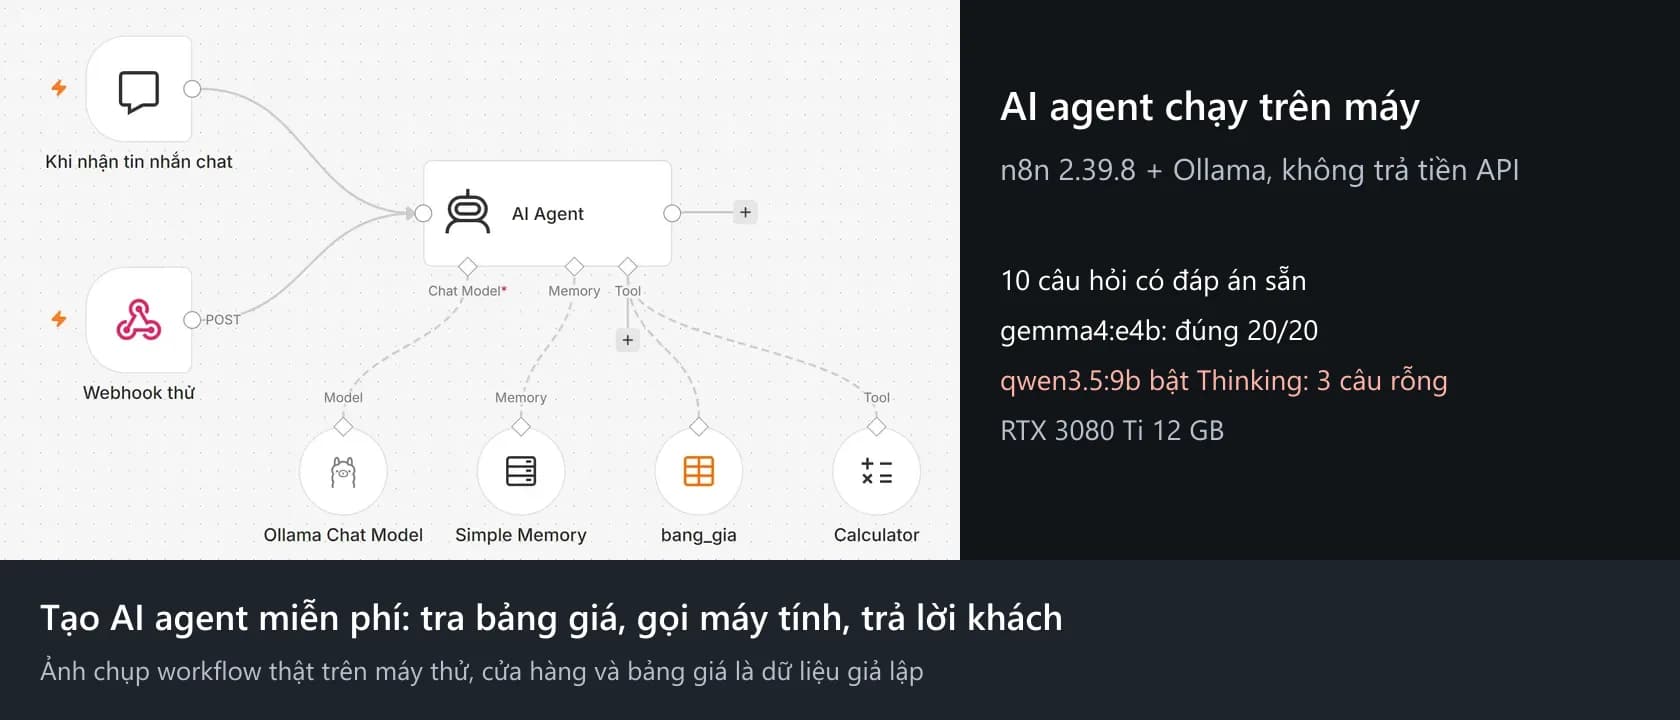
Muốn tạo AI agent miễn phí mà không trả tiền API theo từng lượt hỏi, bạn có thể ghép hai phần mềm chạy ngay trên máy: n8n để dựng luồng và Ollama để chạy mô hình ngôn ngữ. Ngày 18/09/2026, mình dựng một AI agent bán hàng cho cửa hàng cà phê hạt giả lập tên Mây Chiều. Agent phải tra bảng giá, dùng công cụ tính tiền, và biết nói "chưa có thông tin" khi khách hỏi ngoài bảng giá. Mình hỏi nó 10 câu có đáp án sẵn, với ba mô hình khác nhau.
Những gì đo được:
- gemma4:e4b và gemma4:12b trả lời đúng 20/20 câu qua hai lượt thử. Không cấu hình nào bịa ra giờ mở cửa.
- qwen3.5:9b với cài đặt mặc định trả lời rỗng 3 trong 30 câu, cả ba lần đều ngay sau khi gọi công cụ tính.
- Tắt Enable Thinking thì qwen3.5:9b hết trả lời rỗng và nhanh nhất (khoảng 1 giây một câu), nhưng tự nhẩm tiền thay vì gọi công cụ tính.
- Credential Ollama để địa chỉ mặc định
localhostthì không kết nối được trên máy Windows của mình. - Sửa workflow rồi bấm lưu là chưa đủ: webhook vẫn chạy bản cũ cho tới khi bấm Publish lại.
"Miễn phí" ở đây nghĩa là không trả tiền phần mềm và không trả phí API. Chi phí thật là một máy có card màn hình và tiền điện. Cửa hàng, sản phẩm và bảng giá trong bài đều là dữ liệu giả lập để thử.
Tạo AI agent miễn phí cần những gì
Máy thử chạy Windows 11, Ryzen 9 7950X, 64 GB RAM, card RTX 3080 Ti 12 GB. Phần mềm:
- n8n 2.39.8, bản mới nhất trên npm ngày 18/09/2026. Từ bản 2.36, n8n đòi Node.js 24; cách nâng Node có trong bài self host n8n: sao lưu và nâng Node 24. Nếu bạn chưa cài n8n lần nào, bắt đầu từ bài cài n8n trên Windows.
- Ollama 0.34.2 với ba mô hình gemma4:e4b (tải về 9,6 GB), qwen3.5:9b (6,6 GB) và gemma4:12b (7,6 GB). Cách cài, dung lượng và tốc độ từng mô hình nằm trong bài chạy AI trên máy tính bằng Ollama.
Về giấy phép: Ollama theo MIT, Gemma 4 và Qwen3.5 theo Apache 2.0. n8n dùng Sustainable Use License, cho phép dùng và sửa cho mục đích nội bộ của doanh nghiệp hoặc cá nhân, nhưng không cho bán lại n8n như một dịch vụ. Bài n8n là gì giải thích kỹ hơn giới hạn này.
Khi cài n8n bằng npm 11.19, npm cảnh báo 16 gói có script cài đặt chưa được cho phép chạy, trong đó có sqlite3. n8n vẫn khởi động được, và mọi phép thử trong bài chạy bình thường.
Dựng n8n AI agent tư vấn bán hàng
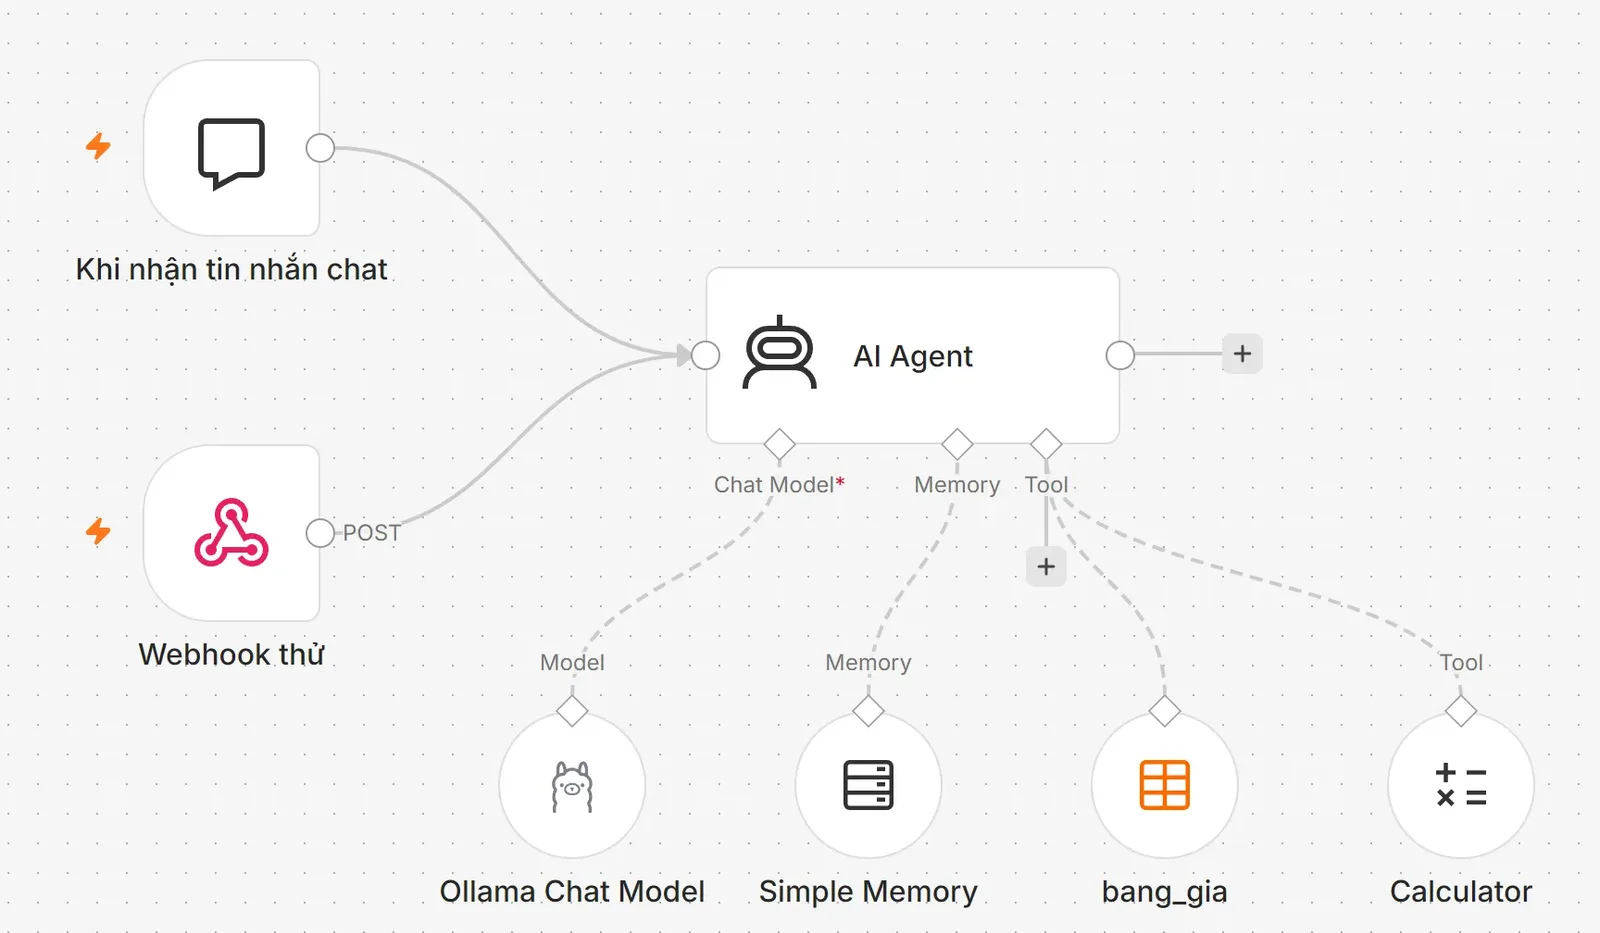
Nếu bạn đang tìm hiểu tạo AI agent như thế nào cho một cửa hàng nhỏ, đây là cấu trúc tối thiểu mình dùng. Tạo AI agent với n8n là ghép các node có sẵn lại với nhau; workflow này gồm bảy node:
- Khi nhận tin nhắn chat (Chat Trigger): để bạn thử trực tiếp trong khung chat của n8n.
- Webhook thử: nhận câu hỏi qua địa chỉ
/webhook/agent-thu, để mình gửi cả 10 câu bằng lệnh. - AI Agent: đọc câu hỏi, tự quyết gọi công cụ nào, rồi viết câu trả lời. Mình bật tuỳ chọn Return Intermediate Steps để xem nó đã gọi những công cụ gì.
- Ollama Chat Model: mô hình chạy trong Ollama trên cùng máy.
- Simple Memory: nhớ vài lượt hội thoại gần nhất theo từng phiên chat.
- bang_gia: công cụ Data table, đọc bảng
san_phamcó sẵn ngay trong n8n, không cần Google Sheets hay tài khoản ngoài. - Calculator: công cụ tính toán.
Bảng san_pham có 5 dòng: Robusta rang mộc 500g 120.000đ (còn 14), Arabica Cầu Đất 250g 145.000đ (còn 6), phin giấy hộp 10 gói 65.000đ (hết hàng), phin nhôm 35.000đ (còn 22), sữa đặc 28.000đ một lon (còn 40).
System message của AI Agent, viết bằng tiếng Việt:
Bạn là nhân viên tư vấn của cửa hàng cà phê hạt Mây Chiều. Trả lời bằng tiếng Việt, ngắn gọn, lịch sự.
- Mọi câu hỏi về sản phẩm, giá, còn hàng: gọi công cụ bang_gia trước, chỉ dùng số liệu trong đó.
- Mọi phép tính tiền: dùng công cụ calculator.
- Thông tin không có trong bảng giá (giờ mở cửa, địa chỉ, sản phẩm không có trong bảng): nói là bạn chưa có thông tin, không tự đoán.
Mô tả công cụ bang_gia, để agent biết khi nào cần gọi nó:
Bảng giá của cửa hàng: trả về toàn bộ sản phẩm gồm tên, giá (đồng), tồn kho, đơn vị. Gọi trước khi trả lời mọi câu hỏi về sản phẩm, giá, còn hàng.Bẫy 1: fetch failed vì địa chỉ localhost
Credential "Ollama API" trong n8n điền sẵn Base URL là http://localhost:11434. Mình giữ nguyên và gửi câu hỏi đầu tiên. Lần chạy báo lỗi sau 541 mili giây:
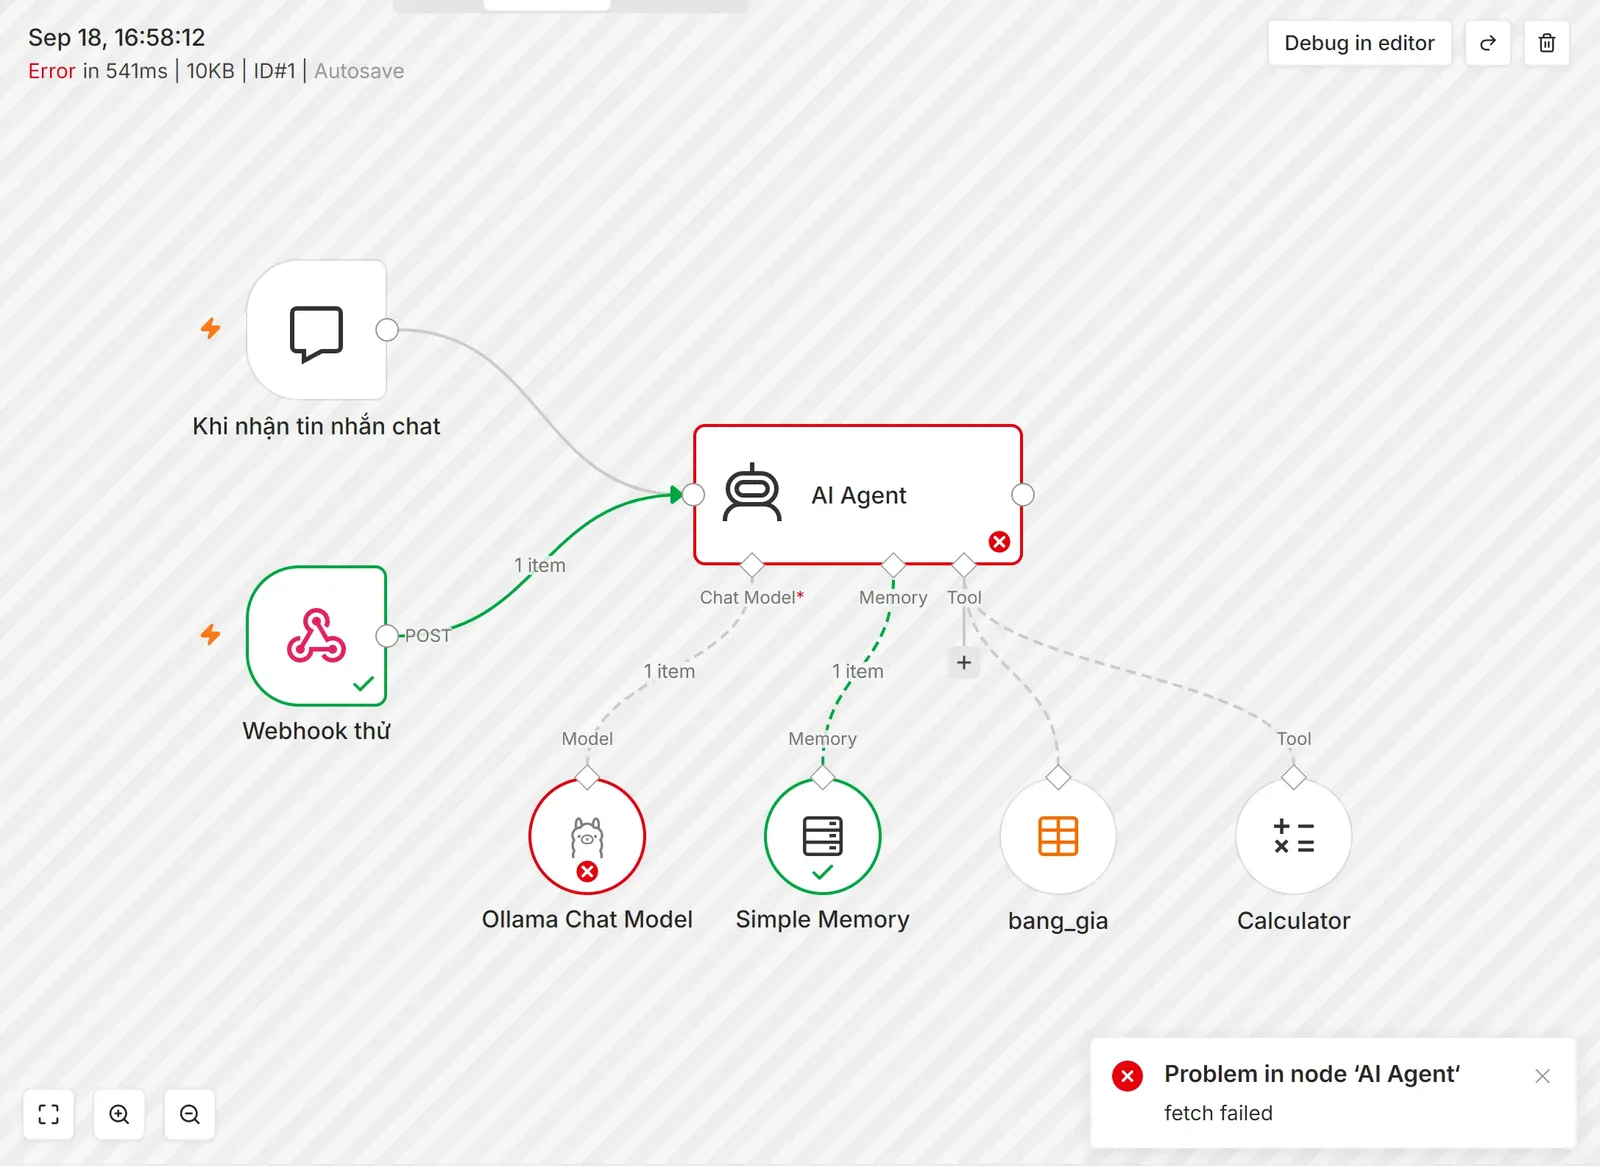
Giao diện chỉ ghi "fetch failed". Nguyên nhân nằm trong cửa sổ terminal đang chạy n8n:
TypeError: fetch failed
connect ECONNREFUSED ::1:11434
::1 là địa chỉ IPv6 của máy. Node.js đã dịch localhost thành ::1, trong khi Ollama chỉ nghe ở địa chỉ IPv4 127.0.0.1:11434 (log khởi động của Ollama ghi OLLAMA_HOST:http://127.0.0.1:11434). Sửa Base URL trong credential thành:
http://127.0.0.1:11434Sau khi sửa, câu hỏi giá Arabica được trả lời đúng 145.000 đồng, có gọi bang_gia, mất 9,2 giây.
Hỏi agent 10 câu: kết quả của ba mô hình
Mười câu gồm hỏi giá, hỏi còn hàng, tính tổng tiền, hỏi sản phẩm không có (trà sữa), một câu chào, và một câu hỏi thông tin không có trong bảng (giờ mở cửa). Bảy câu cần tra bảng giá, bốn câu cần tính tiền. Mỗi câu dùng một phiên chat riêng. Để gửi một câu bằng PowerShell:
[Console]::OutputEncoding = [System.Text.Encoding]::UTF8
$body = @{ cau_hoi = "Mua 2 gói Arabica và 1 phin nhôm thì tổng bao nhiêu?"; session = "khach-1" } | ConvertTo-Json
$r = Invoke-RestMethod -Uri "http://127.0.0.1:5678/webhook/agent-thu" -Method Post -ContentType "application/json" -Body ([System.Text.Encoding]::UTF8.GetBytes($body))
$r.output
$r.intermediateSteps.action.tool
Máy mình chạy n8n ở cổng 5680 nên đổi số cổng tương ứng; cổng mặc định là 5678. Dòng cuối in ra tên các công cụ agent đã gọi.
Kết quả, mỗi lượt là đủ 10 câu:
- gemma4:e4b, cài đặt mặc định (2 lượt): đúng 20/20. Tra bảng giá đủ 14/14 lần cần, gọi công cụ tính 6/8 lần cần. Trung bình 3,0 và 4,0 giây một câu.
- gemma4:12b, cài đặt mặc định (2 lượt): đúng 20/20, tra bảng 14/14, gọi công cụ tính 7/8. Trung bình 7,3 và 4,3 giây; câu đầu tiên mất 37,8 giây vì phải nạp mô hình.
- qwen3.5:9b, cài đặt mặc định (3 lượt): đúng 27/30. Ba câu sai đều là câu trả lời rỗng. Trung bình 2,9 đến 3,6 giây.
- qwen3.5:9b, tắt Enable Thinking (2 lượt): đúng 20/20, trung bình 1,5 và 1,1 giây, nhưng chỉ gọi công cụ tính 2/8 lần cần.
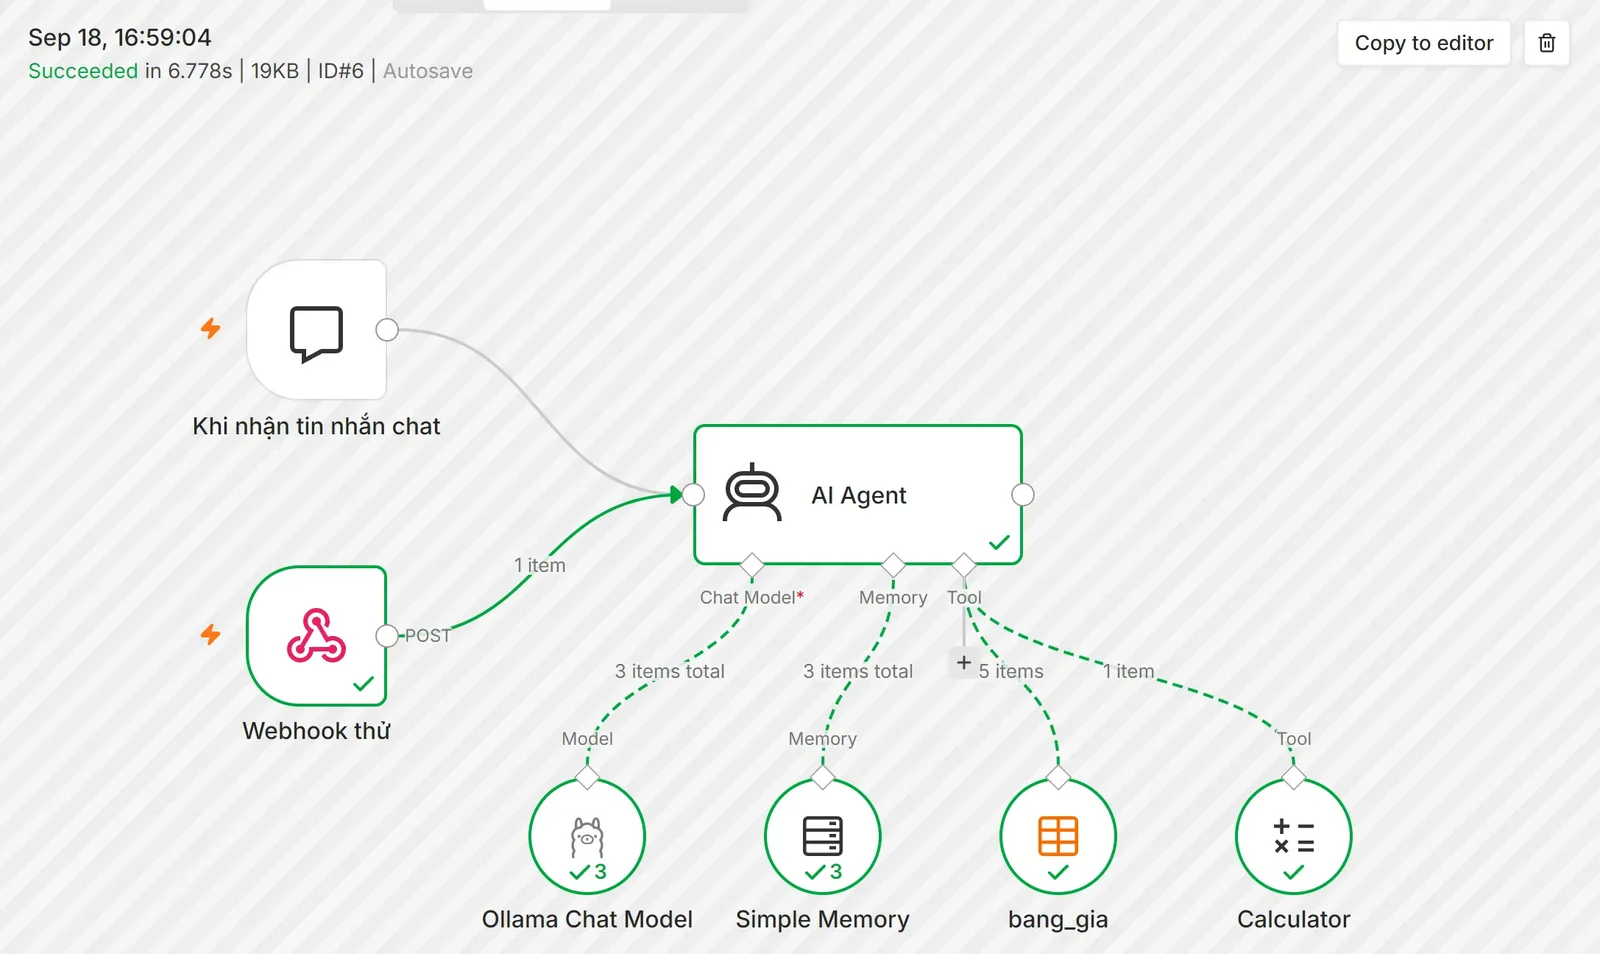
Ở câu hỏi mua 2 gói Arabica và 1 phin nhôm, gemma4:e4b gọi mô hình 3 lần, đọc 5 dòng của bảng giá, gọi Calculator 1 lần và trả lời 325.000 VND sau 6,8 giây.
Với câu giờ mở cửa, cả bốn cấu hình đều trả lời là chưa có thông tin, không cấu hình nào tự nghĩ ra giờ. Ngoài lề: gemma4:e4b chèn một biểu tượng cảm xúc vào lời chào, vì system message không cấm việc này.
Bẫy 2: Enable Thinking bật và câu trả lời rỗng
Khi bạn chưa thêm tuỳ chọn nào vào node Ollama Chat Model, n8n không gửi tham số think cho Ollama, và mô hình vẫn suy nghĩ trước khi trả lời: dữ liệu lần chạy của gemma4:e4b và qwen3.5:9b đều có phần reasoning. Nhiệt độ cũng lấy theo mô hình; lệnh ollama show ghi temperature 1 cho cả ba. Với qwen3.5:9b ở cài đặt này, có 3 lần agent gửi cho khách một câu trả lời trống trơn. Mình mở từng lần chạy để xem:
- Calculator vẫn trả đúng kết quả, ví dụ
144500cho câu 17% của 850.000. - Lượt gọi mô hình ngay sau đó trả về 0 token nội dung, trong khi phần suy nghĩ (reasoning) vẫn có chữ.
- AI Agent nhận chuỗi rỗng và trả nguyên chuỗi rỗng đó ra ngoài.
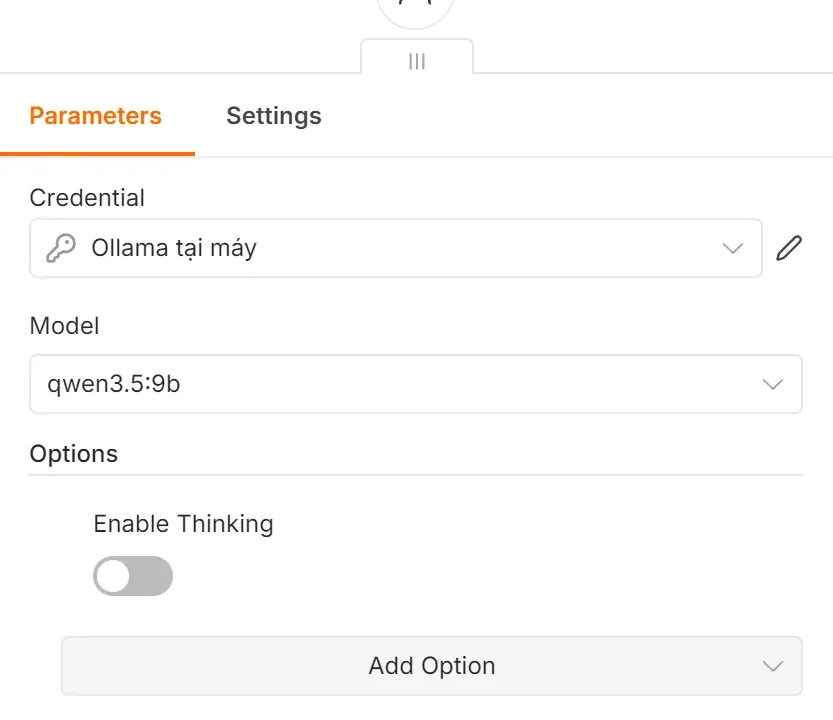
Mình bấm Add Option, thêm Enable Thinking rồi tắt nó. Hai lượt tiếp theo không còn câu rỗng nào, và agent nhanh hơn gấp đôi. Đổi lại, qwen3.5:9b tự nhẩm tiền ở 6 trong 8 lần lẽ ra phải gọi Calculator. Các phép tính trong bộ câu hỏi đơn giản nên vẫn đúng. Một lần nó còn viết phép tính theo cú pháp LaTeX, $2 \times 145.000 + 1 \times 35.000 = 325.000$, và câu trả lời gửi về chứa nguyên chuỗi ký hiệu đó. Kênh chat nào không hiển thị công thức thì khách sẽ đọc thấy cả các dấu đô la lẫn lệnh \times.
Sửa workflow xong phải Publish lại
Workflow đang chạy ở trạng thái Published với qwen3.5:9b. Mình đổi mô hình sang gemma4:e4b, bấm lưu, rồi gửi một câu hỏi qua webhook:
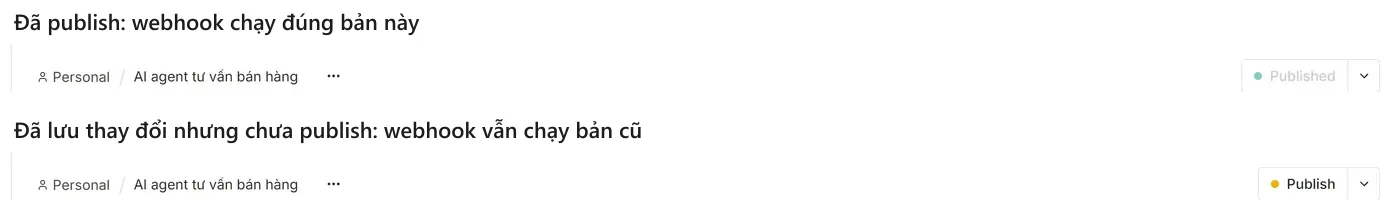
Lần chạy #93 vẫn dùng qwen3.5:9b, và Ollama cũng nạp qwen3.5:9b. Webhook chỉ chạy bản đã publish. Khi thấy nút ở góc phải chuyển sang Publish với chấm vàng, bạn phải bấm nó thì thay đổi mới có hiệu lực với khách.
Chỗ vẫn phải để người quyết định
Một AI agent tư vấn khách hàng chạy trên máy vẫn cần người ở bốn chỗ:
- Tiền. Agent tự nhẩm được phép tính dễ, nhưng ở bài chạy AI trên máy tính, cả ba mô hình đều ghi sai tiền thối khi không được tính từng bước. Đơn hàng thật nên được người kiểm lại trước khi chốt.
- Câu trả lời rỗng. Nếu vẫn bật Thinking, bạn cần một bước bắt câu trả lời trống và chuyển cho nhân viên. Mình chưa dựng bước này.
- Câu hỏi ngoài bảng giá. Agent nói "chưa có thông tin" là đúng, nhưng khách vẫn cần người trả lời tiếp.
- Kết quả dao động. Temperature của các mô hình này là 1, nên chạy lại có thể khác, và mỗi cấu hình mới chạy 2 đến 3 lượt.
Tóm lại, tạo AI agent miễn phí bằng n8n và Ollama là làm được với một máy có card 12 GB, và gemma4:e4b là cấu hình ít lỗi nhất trong lần thử này. Khi cần nối agent với kênh chat thật như fanpage, bài tự động trả lời tin nhắn fanpage bằng n8n nói về những điều kiện phía Meta.
Những gì mình chưa kiểm
- Chạy agent trên máy không có card NVIDIA.
- Hội thoại nhiều lượt dài, khi Simple Memory phải nhớ nhiều.
- Bảng giá hàng trăm dòng, khi dữ liệu đưa vào mô hình dài hơn nhiều.
- Nối vào Zalo, Facebook hay Telegram.
- Tác giả
- Quản trị viên
- Đăng ngày
- 2026-09-18
- Cập nhật
- 2026-09-18
- Thời gian đọc
- 9 phút đọc
- Tất cả bài viết